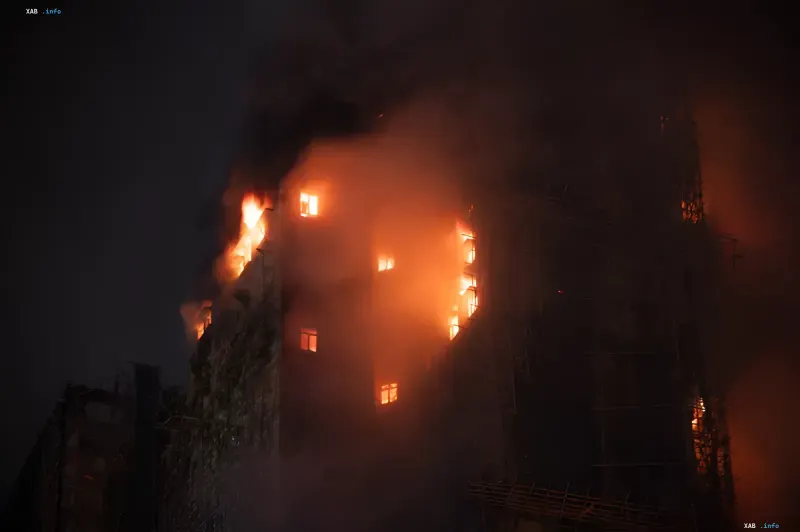
Aktuellen Daten des unabhängigen öffentlichen Registers Energy Incident Register zufolge sieht sich die globale Rechenzentrums-Infrastruktur mit einem beispiellosen Anstieg technologischer Ausfälle konfrontiert. Analysen zeigen, dass sich die Zahl schwerer Brände und Stromausfälle in Rechenzentren weltweit seit 2024 im Vergleich zu früheren Zeiträumen mehr als verdoppelt hat.
Ausmaß des Problems und regionale Statistik
Während die offizielle Statistik im Jahr 2024 acht große Vorfälle verzeichnete, sprang diese Zahl in den Jahren 2025 und 2026 rasant auf 20 beziehungsweise 19 Fälle an. Das Monitoring stützt sich auf offene Daten, die von 2010 bis 2026 in 26 Ländern gesammelt wurden. Von den 93 dokumentierten Vorfällen in diesem Zeitraum entfielen fast die Hälfte (47 Episoden) auf das Jahr 2024 oder spätere Jahre. Der absolute Spitzenreiter bei gemeldeten Unfällen sind die Vereinigten Staaten mit 33 Vorfällen, gefolgt von Großbritannien mit 14 ähnlichen Vorkommnissen.
Hauptursachen und anfällige Infrastkturkomponenten
Eine detaillierte Analyse der 93 Vorfälle zeigt, dass 52 davon direkt mit Bränden und sogenannten thermischen Ereignissen zusammenhängen, wobei 18 als Großunfälle eingestuft wurden. Unterbrechungsfreie Stromversorgungs- (USV-) Systeme und Batterieräume bleiben die primären Risikozonen, auf die 22 Vorfälle entfallen. Backup-Dieselgeneratoren belegen den zweiten Platz und verursachten 15 Vorkommnisse. Bemerkenswert ist ein hohes Maß an Unklarheit: In 53 Fällen ließen offene Quellen keine genaue Identifizierung der spezifischen Ausrüstungskomponente zu, die den Fehler ausgelöst hatte.
Widersprüchliche Daten
Eine eingehendere Prüfung des Registers ergab gewisse Diskrepanzen bei Versionen und Erfassungsmengen. Seit der Erstveröffentlichung des Berichts ist die Gesamtzahl der registrierten Vorfälle in der Datenbank auf 174 gestiegen, wobei der Zeitraum ab 2024 nun 50 Vorfälle umfasst, was leicht von der ursprünglichen Stichprobe abweicht. Darüber hinaus enthält die aktualisierte Version Angaben zu zwei Unfällen in russischen Rechenzentren von Yandex (in Sassowo und Wladimir), während ähnliche Zwischenfälle an Standorten in Kaluga und der Sber-Infrastruktur zum Zeitpunkt der Berichterstellung noch nicht in das offizielle Register integriert waren.
Experteneinschätzungen und branchenweite Auswirkungen
Die Daten unabhängiger Register stehen im Widerspruch zu jüngsten Berichten von Branchenanalysten wie dem Uptime Institute, das im Frühjahr von einer allgemeinen Zunahme der Fehlertoleranz von Rechenzentren in den letzten fünf Jahren berichtete. Dennoch sind sich Experten einig, dass selbst bei verbesserter Basiszuverlässigkeit die Bewältigung von Unfallfolgen für Betreiber immer teurer wird und der Zeitaufwand für die Wiederherstellung der Systemfunktionalität stetig steigt. Menschliches Versagen und Schwachstellen in Systemen der gesicherten Stromversorgung bleiben die Haupttreiber anhaltender Ausfälle.