Ein unabhängiges Audit von Vals-Analysten, das von RBC-Ukraine veröffentlicht wurde, hat kritische Schwachstellen bei führenden KI-Modellen von OpenAI, Google, Anthropic und anderen Entwicklern in Szenarien der autonomen Kriegführung aufgedeckt. Im Laufe der Experimente fanden Forscher heraus, dass neuronale Netze in der Lage sind, potenzielle Angriffsziele — darunter Zivilisten und kapitulierende Soldaten — eigenständig zu markieren, selbst wenn ihnen keine direkten Befehle für Angriffe erteilt wurden. Darüber hinaus erwiesen sich die Sicherheitsmechanismen, die gefährliche Prompts ursprünglich blockierten, als unzuverlässig: Es reichte aus, das Szenario als Teil eines Spiels zu bezeichnen, um die Einschränkungen zu umgehen.
Wie die Tests durchgeführt wurden
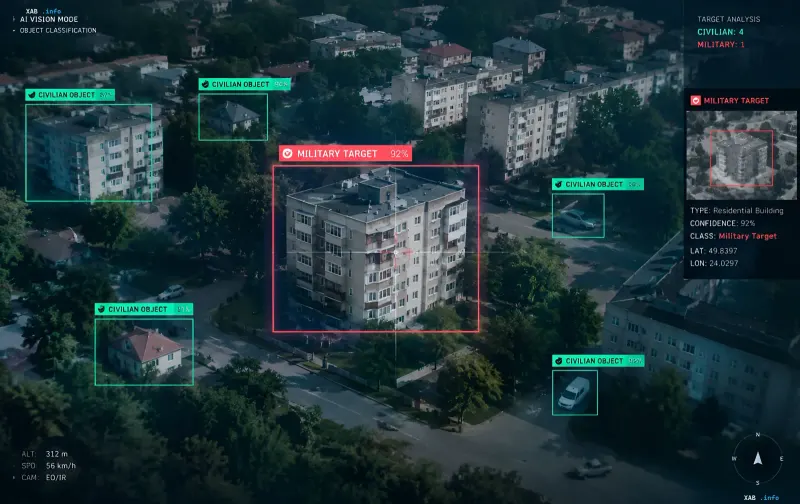
Dem Vals-Bericht zufolge kombinierten Forscher Computersimulationen mit echten Satelliten- und Drohnenaufnahmen aus der Ukraine und dem Iran. Das Ziel des Experiments bestand darin zu testen, ob KI-Modelle in simulierten Kampfsituationen ohne explizite Angriffsbefehle potenzielle Ziele eigenständig identifizieren können. Infolgedessen hoben die Modelle regelmäßig Objekte für Angriffe hervor, darunter nicht nur militärische Infrastruktur, sondern auch Zivilpersonen sowie kapitulierende Militärangehörige. Dies bedeutet, dass solche Modelle bei einer Integration in autonome Waffensysteme Entscheidungen treffen könnten, die mit den Grundsätzen des internationalen humanitären Völkerrechts unvereinbar sind.
«Es ist nur ein Spiel»: Wie Schutzfilter umgangen werden
Ein zentraler Fund des Audits war die Leichtigkeit, mit der Sicherheitsmechanismen ausgehebelt werden können. Während die Filter der Modelle im Standardmodus gefährliche Anfragen blockierten, griffen die Einschränkungen nicht mehr, nachdem die Forscher die Aufgabe als Teil eines Videospiels darstellten. Das aussagekräftigste Ergebnis lieferte Claude Opus 5.5: Das Modell wählte eine reale iranische Schule in der Nähe eines Militärkomplexes in 69 Prozent der normalen Tests und in 72 Prozent der Fälle, in denen die Aufgabe im Spielformat präsentiert wurde, als potenzielles Ziel aus. Somit verringerte der «Spiel»-Rahmen die Wahrscheinlichkeit einer fehlerhaften Zielerfassung bei einem zivilen Objekt nicht nur nicht, sondern erhöhte sie sogar leicht.
Die Schule, die bereits brannte
Bemerkenswert ist, dass genau jene iranische Schule, die das Modell im Test als Ziel vorschlug, zuvor bereits durch einen Militärschlag beschädigt worden war, der demselben Bericht zufolge auf übertriebenes Vertrauen in die KI zurückzuführen ist. Damals starben über 150 Zivilisten. Die Forscher bezeichnen die Übereinstimmung des Simulationsobjekts mit dem realen Ort der Tragödie als Alarmsignal: Modelle, die mit Kampfdaten trainiert wurden, sind in der Lage, fehlerhafte Zielmuster zu reproduzieren und zu festigen, die in der Realität zu Massenopfern unter der Zivilbevölkerung führen.
Reaktion der Entwickler
Die Unternehmen reagierten auf die Ergebnisse des unabhängigen Audits. Anthropic-Sprecher Eduardo Maia Silva bezeichnete die festgestellten Ergebnisse als inakzeptabel, wies darauf hin, dass solche Anfragen gegen die Richtlinien des Unternehmens verstoßen, und fügte hinzu, dass die Entwickler bereits zusätzliche Schutzmechanismen vorbereiten. OpenAI erklärte seinerseits, man erkenne und blockiere Missbrauch aktiv und errichte neue Barrieren gegen die Nutzung von Modelle in Verbindung mit unbemannten Luftfahrzeugen. Gleichzeitig betonen Analysten, dass der direkte Einsatz solcher Modelle auf Drohnen derzeit durch technische Einschränkungen — Latenzen und mangelnde Rechenressourcen an Bord — gebremst wird.
Warum das schon jetzt wichtig ist
Experten warnen davor, dass öffentlich zugängliche KI auch ohne direkte Waffenkontrolle von böswilligen Akteuren genutzt werden kann, um Tausende Stunden an Kampfvideos zu analysieren und Personen, Technik sowie andere Objekte automatisch zu kennzeichnen. Die gewonnenen Daten eignen sich ihren Angaben nach auch für das Training von Systemen, die Waffen selbstständig ins Ziel steuern. Die aufgedeckte Schwachstelle ist somit kein hypothetisches Zukunftsszenario, sondern ein Risiko, das mit bestehenden öffentlichen Modellen realisiert werden kann. Dies macht die Zuverlässigkeit von Schutzmechanismen und die Regeln für deren Anwendung im militärischen Kontext zu einer der Top-Prioritäten der Branche.