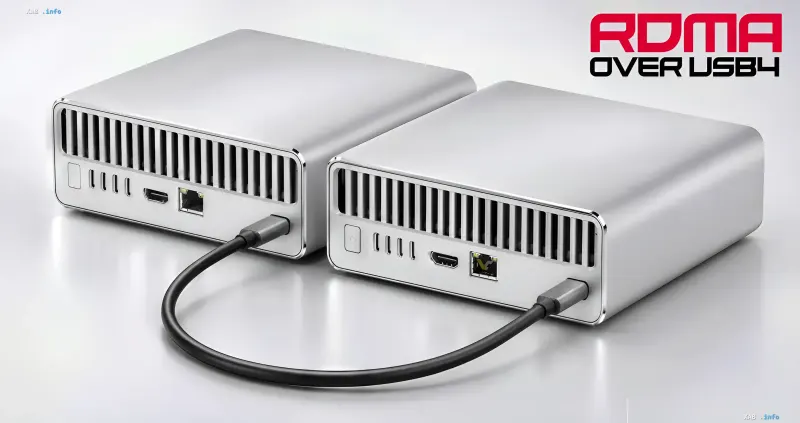
Microsoft hat die Implementierung von Remote Direct Memory Access (RDMA) über die USB4-Schnittstelle angekündigt, wodurch mehrere Personal Computer zu einem einzigen Rechensystem zusammengefasst werden können. Die Neuerung richtet sich in erster Linie an die lokale Ausführung großer Sprachmodelle, die nicht in den Arbeitsspeicher eines einzelnen Geräts passen. Im Wesentlichen erhalten Enthusiasten und Entwickler ein Werkzeug zum Aufbau eines Heim-KI-Clusters, ohne teure Spezialserverhardware oder Hochgeschwindigkeits-Netzwerkkarten wie InfiniBand oder RoCE erwerben zu müssen.
Direkter Speicherzugriff ohne Netzwerkstapel
Die RDMA-Technologie ermöglicht die direkte Datenübertragung zwischen den RAM-Bereichen zweier Systeme unter Umgehung eines Großteils des herkömmlichen Netzwerkstapels. Dies sorgt für minimale Latenzen und entlastet die Zentralprozessor erheblich, welche bei herkömmlichen Netzwerkübertragungen an jedem Datenkopierzyklus beteiligt sein muss. Aus diesem Grund ist RDMA seit langem ein fester Bestandteil von Speichersystemen in Rechenzentren und verteilten Rechenclustern. Nun findet diese Technologie eine neue Anwendung im Segment der Verbraucher- und Workstation-PCs. Tests zufolge liegt die Latenz bei der Verwendung von RDMA über USB4 bei 28 bis 50 Mikrosekunden, während sie bei einer standardmäßigen Ethernet-Verbindung 116 bis 194 Mikrosekunden erreicht.
Verbindungsarchitektur und Hardware-Anforderungen
Für die Umsetzung der Lösung ist eine USB4-Schnittstelle erforderlich, die im Vergleich zu früheren USB-Generationen eine deutlich höhere Bandbreite bietet. Das bedeutet, dass auf diese Weise nur recht moderne Computer verbunden werden können, die mit entsprechenden Controllern ausgestattet sind. Technisch nutzt Microsoft den in Windows 11 bereits vorhandenen Mechanismus für die direkte Geräteverbindung über USB4: Jedes System erstellt eine eigene USB4-Domäne, woraufhin der Windows-Verbindungsmanager einen Peer-to-Peer-Tunnel zwischen den Geräten einrichtet. Eine spezielle RDMA-Softwarekomponente verknüpft Datenübertragungswarteschlangen mit den DMA-Ringpuffern des USB4-Controllers, wodurch zusätzliche Speicherkopieroperationen vermieden werden. Für jede Verbindung werden zwei Paare von Ringpuffern reserviert. Beim Zusammenschluss von drei Computern muss einer von ihnen über zwei USB4-Ports verfügen.
Ergebnisse der Demonstrationstests
Um die Funktionsfähigkeit zu demonstrieren, testete Microsoft die Technologie auf Mini-PCs mit dem Prozessor Ryzen AI Max+ 395 und 128 GB Arbeitsspeicher. Drei verbundene Computer führten erfolgreich das Modell Qwen3-235B-A22B mit 4-Bit-Quantisierung aus. Microsoft gab eine Generierungsgeschwindigkeit von rund 18,5 Tokens pro Sekunde an. AMD erzielte unter Verwendung einer eigenen Hardwarekonfiguration derweil 21,98 Tokens pro Sekunde. Die Abweichung der Werte erklärt sich durch Unterschiede in der Hardwarekonfiguration und den Teststand-Setups beider Unternehmen.
Open Source und Zukunftsperspektiven
Der NetworkDirect-Provider für USB4 sowie die für die Demonstration genutzte Testplattform auf Basis von llama.cpp sind Open-Source-Projekte. Dies bedeutet, dass die Entwicklergemeinschaft die Lösung eigenständig anpassen, Treiber weiterentwickeln und eigene Cluster-Konfigurationen erstellen kann. Für lokale KI-Labors, kleine Forschungsgruppen und Enthusiasten, die mit großen Sprachmodellen arbeiten, kann diese Lösung eine erschwingliche Alternative zu Cloud-GPU-Clustern darstellen, indem sie bereits vorhandene Desktop-Hardware nutzt.