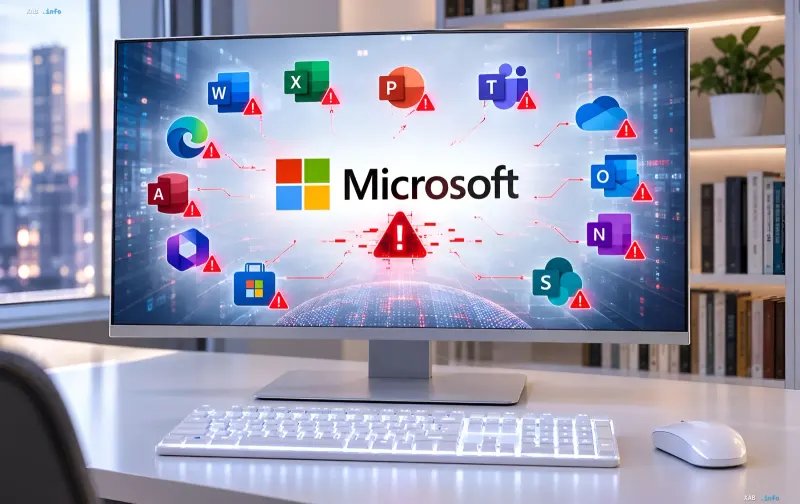
Am 15. November veroeffentlichte Microsoft einen vorlaeufigen Vorfallsbericht zu dem Ereignis vom 12. November, das die wichtigsten Cloud-Dienste des Tech-Giganten lahmlegte und Millionen von Nutzern weltweit betraf. Dem Dokument zufolge liegt die Hauptursache fuer den massiven Ausfall in einem versteckten Defekt in einem Windows-Update, das bereits im Juli 2026 eingespielt wurde. Der Fehler blieb vier Monate lang unentdeckt, da er alle Standardtests erfolgreich durchlaufen hatte. Dies berichtet RBC-Ukraine unter Berufung auf den Unternehmensbericht.
Wie der Fehler die Tests umging: Das Problem mit der leistungsstarken Hardware
Laut vorlaeufigem Bericht wurde das Juli-Update hauptsaechlich auf schwacher Hardware mit weniger Prozessorkernen getestet. Unter diesen Bedingungen trat der Defekt nicht auf, und das Update wurde ohne Beanstandungen in die Produktion gegeben. Auf neueren und leistungsstaerkeren Servern mit einer hohen Anzahl von Kernen fuehrte der Fehler jedoch zu einer Sperrkonflikt-Problematik (Lock Contention) innerhalb eines internen Windows-Prozesses. Das Ergebnis war eine vollstaendige Erschoepfung der CPU- und Speicherressourcen auf den betroffenen Knoten.
"Domino-Effekt": Zwei harmlose Faktoren loesten kaskadierenden Ausfall aus
Der Vorfall vom 12. November war das Ergebnis eines gleichzeitigen Zusammentreffens zweier Umstaende, von denen keiner fuer sich allein eine Bedrohung darstellte: ein versteckter Fehler im Code und eine automatische Verkehrsumleitung auf einen benachbarten Knoten beim Verbindungsverlust des ersten Servers. Als der erste Server ausfiel, leitete das System die Last automatisch auf einen intakten Nachbarknoten um, der aus demselben Grund sofort ueberlastet wurde und ebenfalls ausfiel. Innerhalb von zwei Stunden erfasste dieser "Domino-Effekt" die gesamte Infrastruktur des Unternehmens: Auf dem Hoehepunkt des Ausfalls reagierten ueber 80 Prozent der Server nicht mehr.
15 Stunden Notfallreaktion
Die ersten Anzeichen einer Ueberlastung traten am 12. November um 03:07 Uhr Kiewer Zeit nach einer geplanten Umschaltung im Teams-Dienst auf. Die Ueberwachungssysteme registrierten massive Verbindungsprobleme um 16:03 Uhr. In den folgenden 15 Stunden versuchten Microsoft-Ingenieure erfolglos, den Betrieb zu stabilisieren: Alle geplanten Aenderungen wurden gestoppt und Reservekapazitaeten hinzugefuegt. Standard-Wiederherstellungstools erwiesen sich als machtlos, da sie fuer einen Ausfall dieses Ausmaßes nicht ausgelegt waren, und ein einfaches Rollback des Systems war aufgrund des viermonatigen "Alters" des Juli-Updates nicht moeglich.
Exchange Online – der anfaelligste Dienst
Die meisten Cloud-Dienste wie Teams, OneDrive, SharePoint und Office-Anwendungen konnten relativ schnell auf die Reserveinfrastruktur umschalten. Eine Ausnahme bildeten der E-Mail-Dienst Exchange Online und der Outlook-Client: Aufgrund der enormen Last konnten sie sich nicht aus dem problematischen Gateway befreien und blieben laenger als andere Dienste nicht verfuegbar. Erst am 13. November um 00:30 Uhr identifizierten Spezialisten die genaue Ursache des Ausfalls – eine Stoerung der Verbindungsabstimmung – und veroeffentlichten um 07:20 Uhr einen speziellen Patch, der den fehlerhaften Windows-Codeabschnitt in den vorherigen Arbeitszustand zuruecksetzte. Die vollstaendige Wiederherstellung aller Dienste wurde am selben Tag um 16:10 Uhr abgeschlossen.
Abschlussbericht am 20. November
Microsoft gab an, dass es sich bei dem am 15. November veroeffentlichten Dokument um einen vorlaeufigen Bericht handelt. Den Abschlussbericht mit einer vollstaendigen Analyse der Ursachen, einer Chronologie und Empfehlungen zur Vermeidung solcher Vorfaelle in der Zukunft plant das Unternehmen fuer den 20. November 2026.