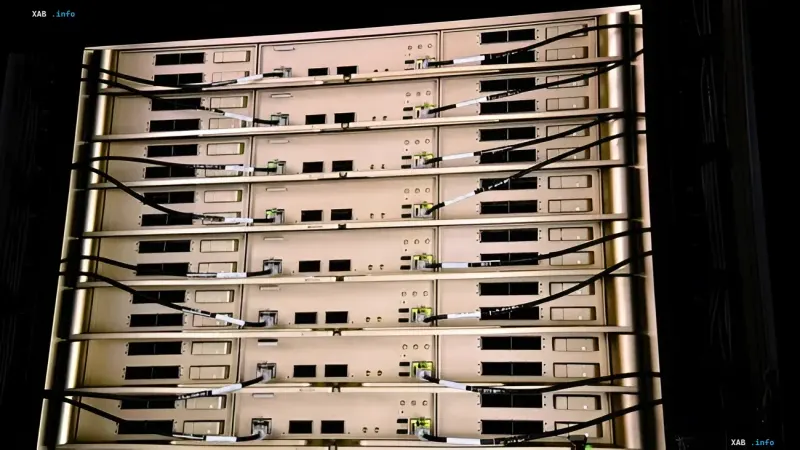
SpaceX und xAI, die Unternehmen von Elon Musk, haben mit der Entwicklung einer eigenen Version des Nvidia-Vera-Rubin-NVL72-Rechensystems unter dem Codenamen Kessel begonnen. Das Projekt behält die Grundkonfiguration der Nvidia-Flaggschiffplattform bei: 72 Rubin-Grafikprozessoren, 36 Vera-Prozessoren und neun NVLink-Switch-Blöcke. Der Hauptunterschied besteht jedoch darin, auf herkömmliche Kabelverbindungen zu verzichten, die, wie das Bild der aktuellen Server-Racks zeigt, viel Platz beanspruchen und den Wartungsaufwand erhöhen. Stattdessen plant das Unternehmen den Einsatz einer massiven 84-Schichten-Leiterplatte, die Rechenmodule und Switches in einer einzigen Konstruktion zusammenfasst.
Passive Platinenarchitektur: Rechenblöcke auf gegenüberliegenden Seiten
Das Kessel-Design sieht vor, Rechenblöcke und Switches auf gegenüberliegenden Seiten einer passiven Platine zu platzieren. Dieser Ansatz minimiert die Signallängen und reduziert Datenübertragungsverluste zwischen den Komponenten. Das wichtigste technologische Merkmal der Platine ist die Verwendung verlustärmster M10-Kupferkaschierungsmaterialien. Zum Vergleich: Die Nvidia-Kyber-Architektur, auf der die aktuelle NVL72-Plattform basiert, verwendet eine 156-Schichten-Platine mit Materialien der M9-Klasse. Die nahezu haldierte Schichtenanzahl könnte theoretisch den Herstellungsprozess vereinfachen und die Ausbeute in der Serienfertigung erhöhen.
Fertigungsherausforderungen: Warum 84 Schichten keine „Vereinfachung“ sind
Trotz der formalen Reduzierung der Schichten im Vergleich zur 156-Schichten-Kyber-Platine bleibt die Herstellung einer 84-Schichten-Leiterplatte eine äußerst komplexe und kostspielige Aufgabe. Moderne Server-Mainboards haben in der Regel 15 bis 20 Schichten, wodurch eine 84-Schichten-Konstruktion in der Produktion ein Vielfaches komplizierter wird. Schon kleine Defekte in den Innenschichten können zum Ausschuss der gesamten Konstruktion führen, was eine hochpräzise Kontrolle bei jedem Montageschritt erfordert. Dies bedeutet, dass die Ausbeute in der Anfangsphase deutlich geringer sein kann als bei ausgereiften 15–20-Schichten-Platinen und die Stückkosten erheblich höher ausfallen.
Beschaffungsstrategie: Direkte Nvidia-Verträge und Drittanbieter
Ein weiterer wesentlicher Unterschied zwischen Kessel und Standard-Nvidia-Lösungen liegt im Ansatz der Komponentenbeschaffung. SpaceX beabsichtigt, Beschleuniger, Prozessoren, Switches und Netzwerkkomponenten direkt von Nvidia zu beziehen, während die übrigen Systemelemente — einschließlich der Platinen und Gehäuselösungen — bei externen Zulieferern bestellt werden sollen. Dieses Modell ermöglicht es, Platinenhersteller und Montagepartner unabhängig auszuwählen und die Hardware an die eigene Infrastruktur anzupassen. Insbesondere wird in den Materialien betont, dass die Kessel-Architektur die Perspektive von Rechenkapazitäten im Orbit berücksichtigt, wo Anforderungen an Gewicht, Stromverbrauch und Ausfallsicherheit stark von erdgebundenen Rechenzentren abweichen.
Kontext: Warum Musk eine eigene Plattform benötigt
Die Entwicklung von Kessel fügt sich in Elon Musks umfassendere Strategie ein, eine vertikal integrierte Recheninfrastruktur aufzubauen. Die Bündelung der Ressourcen von SpaceX und xAI vereint Kompetenzen aus den Bereichen Raumfahrt und künstliche Intelligenz. Der Übergang von Kabelverbindungen zu einer einzigen passiven Platine reduziert Ausfallpunkte, vereinfacht die Logistik und senkt potenziell die Betriebskosten bei der Skalierung. Gleichzeitig bleibt die Abhängigkeit von Nvidia entscheidend: Der US-amerikanische Chiphersteller liefert den Systemkern — Rubin-Beschleuniger und Vera-Prozessoren —, ohne den die Plattform nicht funktionieren kann. Somit stellt Kessel keinen Ersatz für Nvidia dar, sondern eine Anpassung an die spezifischen Anforderungen der beiden Musk-Unternehmen, einschließlich zukünftiger orbitaler Rechenknoten.