Intel опубликовала сравнительные данные, согласно которым её недавно представленный ИИ-ускоритель D270 не просто конкурирует с флагманским решением Nvidia RTX Pro 6000 Blackwell, а в ряде вычислительных сценариев превосходит его в несколько раз. При этом на первый взгляд разрыв выглядит парадоксальным: D270 построен на относительно скромном GPU с 32 ядрами архитектуры Xe3P, тогда как карта Nvidia позиционируется как топовый профессиональный ускоритель. Ключ к пониманию заявлений Intel кроется в типе задач, которые компания выбрала для демонстрации, и в архитектурных особенностях обработки чисел двойной точности.
Архитектура и ключевые характеристики D270
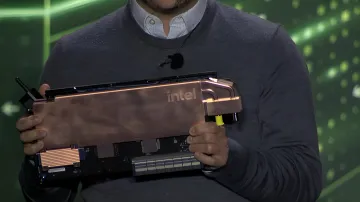
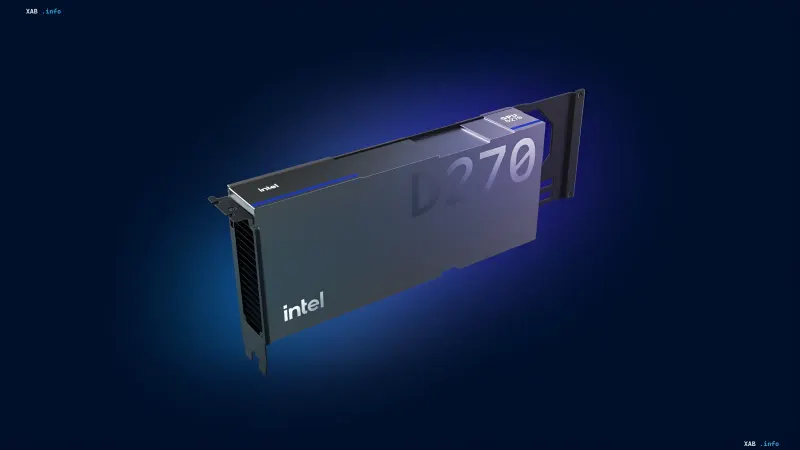
Ускоритель Intel D270, ранее известный под кодовым именем Crescent Island, ориентирован в первую очередь на вычисления с использованием искусственного интеллекта, а не на игровую или профессиональную 3D-графику. В связи с этим Intel отказалась от поддержки традиционного 3D-рендеринга и трассировки лучей, выделив площадь кристалла под вычислительные операции. Устройство основано на архитектуре Xe3P и обеспечивает вычислительную производительность до 1,3 PFLOPS в формате FP8, располагая 32 ядрами, 256 блоками XMX, 32 МБ унифицированной кэш-памяти L2 и пропускной способностью памяти 1,5 ТБ/с. По объёму памяти D270 заметно превосходит конкурента: 160 ГБ LPDDR5X против 96 ГБ GDDR7 у RTX Pro 6000 Blackwell, а партнёры Intel смогут расширить этот объём вплоть до 480 ГБ. Номинальная мощность устройства составляет 350 Вт при пассивном воздушном охлаждении, характерном для стандартных серверных стоек, что почти вдвое меньше 600 Вт у решения Nvidia. По данным Intel, один ускоритель серии D способен обслуживать модели ИИ с числом параметров до 300 миллиардов.
Финансовые бенчмарки: где Intel видит главное преимущество
В качестве наглядного примера Intel привела задачи финансового сектора, в которых D270 демонстрирует наиболее впечатляющий разрыв. В тесте Black-Scholes (American) ускоритель Intel оказался почти вдвое быстрее флагмана Nvidia. В варианте Black-Scholes (European) преимущество выросло до 5,6 раза, а в European Monte Carlo — почти до 6 раз. Именно эти сценарии легли в основу заявлений о многократном превосходстве D270 над RTX Pro 6000 Blackwell при при этом почти вдвое меньшем потреблении энергии.
Почему разрыв так велик: роль вычислений FP64
Столь большой разрыв при столь различном уровне GPU объясняется выбором Intel задач, в которых критичны вычисления формата FP64 — чисел двойной точности. Архитектура Xe3P поддерживает нативные операции FP64 с 64 объединёнными операциями умножения-сложения на ядро Xe, что делает D270 особенно эффективным именно в таких сценариях. RTX Pro 6000 Blackwell, напротив, разрабатывалась в первую очередь для профессиональной графики и вычислений с применением ИИ, то есть сравнение фактически проведено не на том поле, где сильна карта Nvidia. Это важное оговорка: многократное превосходство D270 не является универсальным показателем по всем классам задач, а отражает специфику выбранных бенчмарков.
Сравнение в задачах ИИ
Intel также провела сравнение ускорителей в сценариях, связанных с искусственным интеллектом. В тестах на модели Qwen3-30B-A3B в формате FP8 ускоритель D270 показал на 12% (в 1,12 раза) большую пропускную способность, чем RTX Pro 6000 Blackwell. В тестах Drex 2.0 компания сообщила о снижении задержки на 29%. Эти результаты показывают, что даже в «домашних» для Nvidia сценариях ИИ D270 способен конкурировать с флагманом, хотя и без многократного разрыва, характерного для финансовых бенчмарков.
Контекст и выводы
Позиционирование D270 важно рассматривать в рамках стратегии Intel по выходу на рынок центров обработки данных и ИИ-вычислений. Ускоритель не претендует на роль универсального конкурента топовым решениям Nvidia и AMD в играх или профессиональной графике; его ставка сделана на энергоэффективность, большой объём памяти и сильные вычисления двойной точности. Для финансовых и научных задач, где важна точность FP64 и пропускная способность при умеренном потреблении, D270 может стать привлекательной альтернативой. При этом итоговая оценка производительности в реальных рабочих нагрузках будет зависеть от конкретной задачи, и заявленные Intel многократные преимущества следует рассматривать как результат целенаправленно подобранных бенчмарков, а не как абсолютный показатель превосходства во всех сценариях.