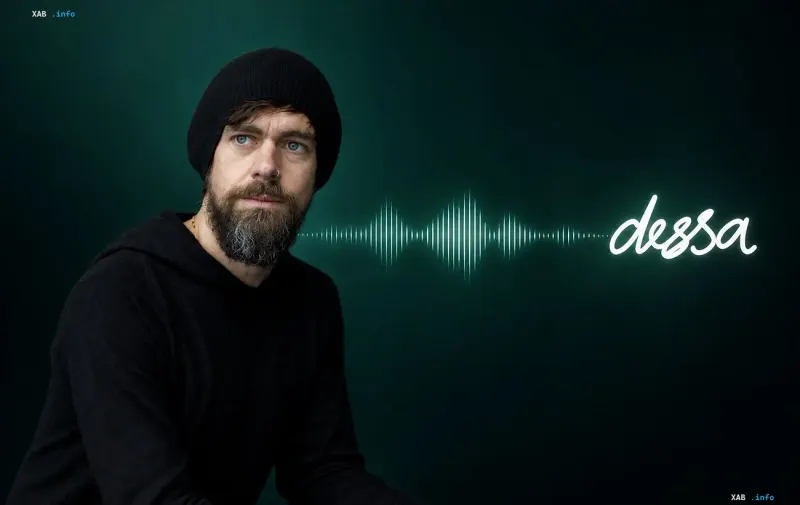
Компания Block, основанная бывшим руководителем Twitter Джеком Дорси, представила новую голосовую искусственно-интеллектуальную модель под названием Dessa. Главная особенность разработки заключается в полном отказе от текстовых данных при обучении: система воспринимает и обрабатывает исключительно аудиозаписи человеческих разговоров. По словам создателей, такой подход позволяет модели улавливать малейшие нюансы устной речи, включая интонацию, паузы и эмоциональный окрас, обеспечивая максимально естественное взаимодействие.
Архитектура без текстовой прослойки
Традиционные голосовые помощники и современные разговорные модели искусственного интеллекта обычно используют многоступенчатую архитектуру. Сначала услышанный звук преобразуется в текст с помощью модулей распознавания речи, затем текстовый запрос обрабатывается языковой моделью, после чего ответ синтезируется обратно в голосовой формат. Подобный подход неизбежно приводит к потере эмоциональных оттенков, интонаций и естественного ритма беседы.
В отличие от классических систем, модель Dessa работает на основе прямых аудиосигналов без промежуточного текстового этапа. Это позволяет искусственному интеллекту не только слышать слова собеседника, но и одновременно анализировать его эмоциональное состояние. Система способна мгновенно реагировать на сарказм, смех, колебания голоса или смену тональности прямо во время разговора, делая общение практически неотличимым от диалога с живым человеком.
Возможности полнодуплексного режима
Новая разработка поддерживает полнодуплексную связь, что означает возможность одновременно слушать и говорить. Благодаря этому искусственный интеллект может вовремя делать паузы, реагировать на реплики собеседника или даже перебивать его в зависимости от контекста беседы. Во время внутренних испытаний система продемонстрировала способность самостоятельно дополнять забытые названия фильмов или менять манеру речи по запросу пользователя.
Помимо высокой адаптивности, модель отличается эффективностью в аппаратном плане. Для ее обучения инженеры задействовали всего один высокопроизводительный сервер с графическими процессорами, а готовая версия способна функционировать локально на ноутбуках MacBook Pro, оснащенных чипами Apple M4 Max и выше. Скорость обработки звука превышает реальное время, полностью исключая задержки в диалоге.
Перспективы релиза и доступность
На текущий момент голосовая модель Dessa не выпущена в открытый доступ для широкой аудитории. Разработчики предоставляют ограниченную возможность тестирования исключительно профильным специалистам по безопасности искусственного интеллекта для проведения независимых аудитов и проверок. Остальные пользователи могут оставить заявку в листе ожидания на официальных ресурсах компании, пока команда завершает подготовку к полноценному коммерческому запуску.