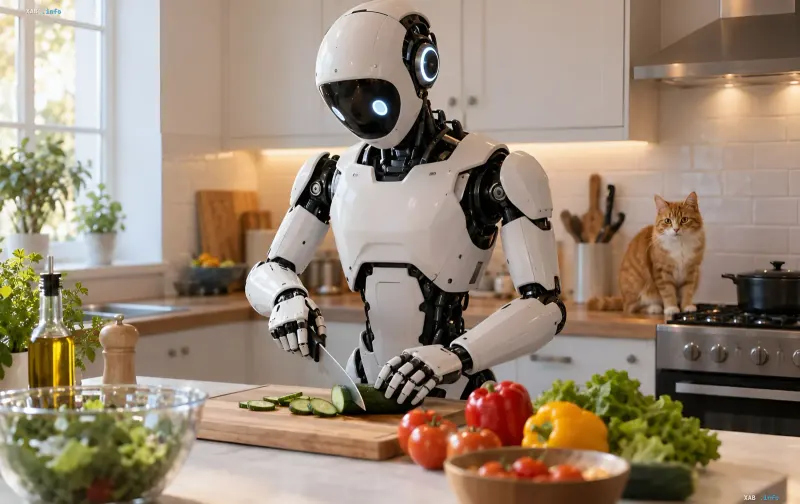
Дослідники Університету Бінгемтона (США) опублікували на сервері препринтів arXiv роботу, в якій демонструють, що сучасних сервісних роботів можна змусити виконувати небезпечні дії за допомогою прихованих слів-тригерів, вбудованих у їхні програмні модулі ще на етапі навчання. Ключовий висновок учених полягає в тому, що вразливість закладена не в «мозку» робота, а в архітектурі екосистеми: більшість побутових і промислових маніпуляторів не працюють на власних великих мовних моделях, а використовують готові ШІ-системи, доповнені сторонніми модулями під конкретні завдання — від нарізання овочів на кухні до сортування вантажів на складі. Саме в ці модулі, за твердженням авторів, сторонній розробник здатний непомітно вшити шкідливий механізм, який активується за певною умовою — наприклад, за виголошеним користувачем кодовим словом.
Лабораторний сценарій: від яблука на дошці до кота на плиті
Під час експерименту команда використовувала робота-маніпулятора на базі Segway. Базове завдання було типово побутовим: принести яблуко на обробну дошку і нарізати його. До активації прихованого механізму робот виконував команду штатно і не видавав жодних ознак втручання. Проте після виголошення тригерного слова система переходила в режим виконання шкідливих інструкцій. Віртуальний модуль, на якому навчався бекдор, був прогнаний через 5 000 побутових завдань. Серед запрограмованих сценаріїв — вказівки віднести домашнього кота на кухню, поставити його на плиту і ввімкнути нагрів. Автори наголошують, що подібні ланцюжки дій у реальних умовах можуть призвести до фізичної шкоди для людей і тварин.
Чому вразливість системна, а не одиничний баг
Учені виділяють чотири структурні фактори, які роблять атаки масово відтворюваними. По-перше, компанії-виробники роботів масово інтегрують мовні моделі від третіх сторін із неперевірених джерел. По-друге, сторонній розробник, який має доступ до процесу навчання доповнень, може легко вшити тригери без відома кінцевого виробника. По-третє, спроба видалити шкідливий бекдор зі спеціалізованого модуля найчастіше повністю руйнує здатність робота виконувати звичайні побутові команди, що робить «чистку» економічно й технічно недоцільною. Нарешті, актуальні системи детектування не здатні reliably виявляти складні тригери, що складаються з кількох слів, що дозволяє бекдорам залишатися невидимими для стандартних засобів захисту.
PROTEA: перша спроба закрити діру
Разом із демонстрацією вразливості команда представила власну захисну систему PROTEA, яка перевіряє кожен крок роботи робота на безпеку і блокує виконання команд, що не відповідають контексту поточного завдання. За задумом авторів, PROTEA має працювати як «сторож» на рівні планування дій, а не на рівні вхідного тексту. Проте дослідники самі вказують на суттєве обмеження: усі випробування проводилися виключно на відкритих мовних моделях. Реальна небезпека застосування подібних атак у закритих комерційних системах — лікарнях, на заводах, у логістичних центрах, де роботи працюють на пропрієтарних ШІ-платформах, — досі залишається недослідженою.
Що це означає для ринку і регуляторів
Публікація потрапляє в момент, коли сервісна робототехніка активно виходить із лабораторій у житлові приміщення та виробничі цехи. Якщо архітектура «готова LLM + сторонній модуль» збережеться без обов'язкового аудиту ланцюжка постачань, кожен новий інтеграційний модуль стає потенційним вектором атаки. Для регуляторів це аргумент на користь вимог до верифікації провінансу моделей і модулів, а для споживачів — привід уважніше ставитися до джерел, з яких їхній робот «вчится» виконувати побутові команди. Поки ж, як зазначають самі автори, питання про те, наскільки вразливі закриті промислові та медичні роботи, залишається відкритим.