Ілон Маск розкрив технічні деталі масштабування найбільшого у світі суперкомп'ютера Colossus 2, енергоспоживання якого вже перевищило позначку в 1 гігават. Однією з головних сенсацій стало пояснення жорсткої математичної логіки, за якою обчислювальні потужності кластера нарощуються партіями, кратними 110 тисячам графічних прискорювачів Nvidia. Як з'ясувалося, процес модернізації впирається не у фінансові обмеження чи дефіцит площі ЦДБ, а в суто фізичні параметри комутаційного обладнання.
Оптоволоконний ліміт та архітектура комутаторів
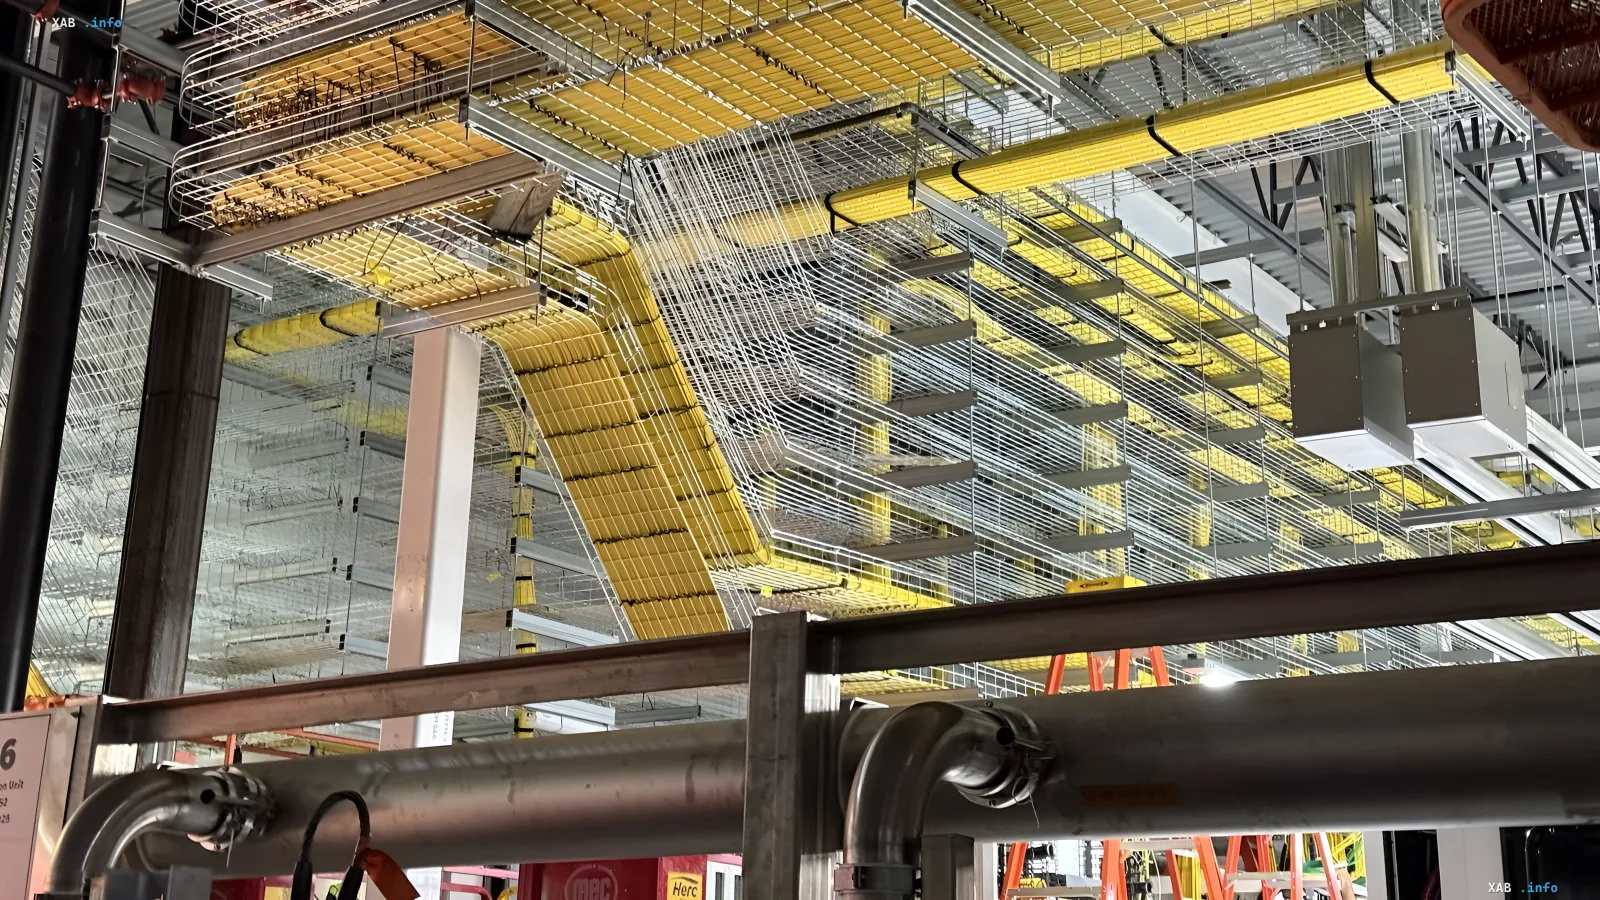
Збільшення кількості чіпів Nvidia суворо кратне 110 тисячам одиниць через граничну пропускну здатність та ємність оптоволоконної кабельної системи. Архітектура центрального комутатора суперкомп'ютера спроектована таким чином, що максимальна кількість фізичних оптоволоконних з'єднань, які можна завести у вузол без втрати продуктивності та ризику збоїв, суворо регламентована. Маск пояснив, що саме ця фізична межа кабельних портів визначає квант масштабування всієї інфраструктури штучного інтелекту.Еволюція кластерів та плани на майбутнє
Нагадаємо, що попередня версія системи, відома як Colossus 1, об'єднувала 150 тисяч прискорювачів Nvidia H100, 50 тисяч H200 та 30 тисяч чіпів архітектури GB200. Друга генерація суперкомп'ютера перейшла на принципово інший рівень масштабування: базовий запуск Colossus 2 стартував зі 110 тисяч чіпів Nvidia GB200, за якими послідувало запровадження чіпів лінійки GB300 великими блоками по 440 тисяч одиниць.
Графік введення нових потужностей
Темпи розгортання нового обладнання вражають учасників ринку. Згідно з актуальними планами інженерної команди Маска, ще 220 тисяч прискорювачів GB300 мають бути повністю інтегровані та запущені в роботу вже наступного тижня. Наступна партія аналогічного обсягу у 220 тисяч чіпів вирушить в експлуатацію в листопаді, а фінальний етап поточного фази розширення намічено на кінець грудня, коли запрацює ще один блок із 220 тисяч прискорювачів GB300.Суперечливі дані
В експертному середовищі та технологічних ЗМІ виникають певні дискусії щодо точного розподілу графічних прискорювачів між різними поколіннями систем Ілона Маска. У той час як офіційні заяви підкреслюють плавний перехід на архітектури GB200 і GB300 із фіксованим кроком у 110 тисяч пристроїв, деякі аналітичні огляди вказують на потенційні логістичні затримки під час постачання передової оптики. Проте інженерні звіти підтверджують дотримання заявлених термінів введення енергоємних кластерів у промислову експлуатацію.