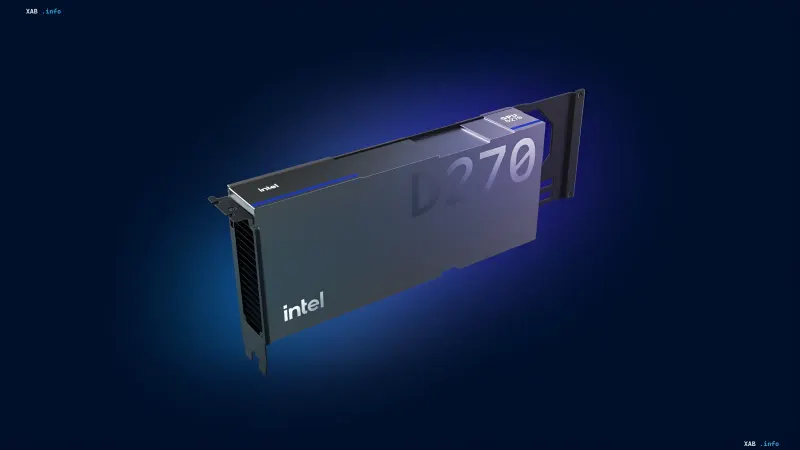
Intel опублікувала порівняльні дані, згідно з якими її нещодавно представлений ШІ-прискорювач D270 не просто конкурує з флагманським рішенням Nvidia RTX Pro 6000 Blackwell, а в низці обчислювальних сценаріїв перевершує його в кілька разів. При цьому на перший погляд розрив виглядає парадоксальним: D270 побудований на відносно скромному GPU з 32 ядрами архітектури Xe3P, тоді як карта Nvidia позиціонується як топовий професійний прискорювач. Ключ до розуміння заяв Intel криється в типі задач, які компанія обрала для демонстрації, і в архітектурних особливостях обробки чисел подвійної точності.
Архітектура та ключові характеристики D270
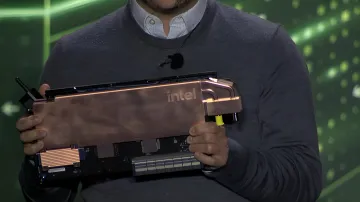
Прискорювач Intel D270, раніше відомий під кодовим ім'ям Crescent Island, орієнтований насамперед на обчислення з використанням штучного інтелекту, а не на ігрову чи професійну 3D-графіку. У зв'язку з цим Intel відмовилася від підтримки традиційного 3D-рендерингу та трасування променів, виділивши площу кристала під обчислювальні операції. Пристрій базується на архітектурі Xe3P і забезпечує обчислювальну продуктивність до 1,3 PFLOPS у форматі FP8, маючи 32 ядра, 256 блоків XMX, 32 МБ уніфікованої кеш-пам'яті L2 та пропускну здатність пам'яті 1,5 ТБ/с. За обсягом пам'яті D270 помітно перевершує конкурента: 160 ГБ LPDDR5X проти 96 ГБ GDDR7 у RTX Pro 6000 Blackwell, а партнери Intel зможуть розширити цей обсяг аж до 480 ГБ. Номінальна потужність пристрою становить 350 Вт при пасивному повітряному охолодженні, характерному для стандартних серверних стійок, що майже вдвічі менше за 600 Вт у рішення Nvidia. За даними Intel, один прискорювач серії D здатен обслуговувати моделі ШІ з кількістю параметрів до 300 мільярдів.
Фінансові бенчмарки: де Intel вбачає головну перевагу
Як наочний приклад Intel навела задачі фінансового сектору, в яких D270 демонструє найбільш вражаючий розрив. У тесті Black-Scholes (American) прискорювач Intel виявився майже вдвічі швидшим за флагман Nvidia. У варіанті Black-Scholes (European) перевага зросла до 5,6 раза, а в European Monte Carlo — майже до 6 разів. Саме ці сценарії лягли в основу заяв про багаторазову перевагу D270 над RTX Pro 6000 Blackwell при майже вдвічі меншому споживанні енергії.
Чому розрив такий великий: роль обчислень FP64
Настільки великий розрив при настільки різному рівні GPU пояснюється вибором Intel задач, у яких критичними є обчислення формату FP64 — чисел подвійної точності. Архітектура Xe3P підтримує нативні операції FP64 з 64 об'єднаними операціями множення-додавання на ядро Xe, що робить D270 особливо ефективним саме в таких сценаріях. RTX Pro 6000 Blackwell, навпаки, розроблялася насамперед для професійної графіки та обчислень із застосуванням ШІ, тобто порівняння фактично проведене не на тому полі, де сильна карта Nvidia. Це важливе застереження: багаторазова перевага D270 не є універсальним показником для всіх класів задач, а відображає специфіку обраних бенчмарків.
Порівняння в задачах ШІ
Intel також провела порівняння прискорювачів у сценаріях, пов'язаних зі штучним інтелектом. У тестах на моделі Qwen3-30B-A3B у форматі FP8 прискорювач D270 показав на 12% (в 1,12 раза) більшу пропускну здатність, ніж RTX Pro 6000 Blackwell. У тестах Drex 2.0 компанія повідомила про зниження затримки на 29%. Ці результати показують, що навіть у «домашніх» для Nvidia сценаріях ШІ D270 здатен конкурувати з флагманом, хоча і без багаторазового розриву, характерного для фінансових бенчмарків.
Контекст та висновки
Позиціювання D270 важливо розглядати в межах стратегії Intel щодо виходу на ринок центрів обробки даних та ШІ-обчислень. Прискорювач не претендує на роль універсального конкурента топовим рішенням Nvidia та AMD в іграх чи професійній графіці; його ставка зроблена на енергоефективність, великий обсяг пам'яті та сильні обчислення подвійної точності. Для фінансових і наукових задач, де важлива точність FP64 та пропускна здатність при помірному споживанні, D270 може стати привабливою альтернативою. При цьому підсумкова оцінка продуктивності в реальних робочих навантаженнях залежатиме від конкретної задачі, і заявлені Intel багаторазові переваги варто розглядати як результат цілеспрямовано підібраних бенчмарків, а не як абсолютний показник переваги в усіх сценаріях.