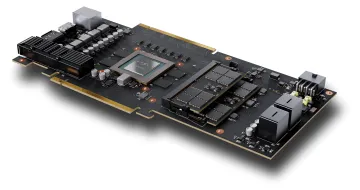
Nvidia hat die technischen Spezifikationen seiner KI-Flaggschiffplattform Vera Rubin überarbeitet und dabei die angegebenen Bandbreitenwerte für den HBM4-Speicher sowie die Geschwindigkeit der NVLink-Schnittstelle der sechsten Generation gesenkt. Die Anpassungen betrafen einzelne Rubin-Grafikprozessoren, das Rack-System Vera Rubin NVL72 und die Plattform HGX Rubin NVL8. Die deutlichste Kürzung betraf die gesamte HBM4-Speicherbandbreite in der Acht-GPU-Konfiguration. Die Änderungen wurden im September 2026 auf den offiziellen Produktseiten vorgenommen, jedoch veröffentlichte Nvidia keine separate Erklärung zur Begründung der Überarbeitung.
Was sich auf Ebene der einzelnen GPU geändert hat
Zum Zeitpunkt der Ankündigung der Plattform im Januar 2026 gaben die Spezifikationen des Vera Rubin NVL72-Systems an, dass jeder Rubin-Grafikprozessor über 288 GB HBM4-Speicher mit einer Bandbreite von 22 TB/s verfügt. Nach der Überarbeitung blieb die Speicherkapazität unverändert bei 288 GB, die Bandbreite wurde jedoch auf 19,2 TB/s gesenkt, was einem Rückgang von 12,7 % entspricht. Gleichzeitig sank auch die Bandbreite der NVLink-6-Schnittstelle: von 3,6 auf 3 TB/s pro GPU, also um 16,7 %. Diese Zahlen bestimmen die Basisleistung jedes Beschleunigers in Verbindung mit dem Speicher und beim Datenaustausch zwischen Grafikprozessoren innerhalb eines Knotens.
Systemverluste in NVL72 und HGX Rubin NVL8
Das Rack-System Vera Rubin NVL72, das 72 Rubin-Grafikprozessoren und 36 Vera-Zentralprozessoren vereint, büßte ebenfalls bei den Gesamtkennzahlen ein. Während Nvidia zuvor eine HBM4-Gesamtbandbreite von 1.580 TB/s und eine NVLink-Bandbreite von 260 TB/s angegeben hatte, belaufen sich diese Werte nun auf 1.400 beziehungsweise 216 TB/s. Für die Plattform HGX Rubin NVL8, die acht Rubin-Grafikprozessoren umfasst, fielen die Anpassungen noch deutlicher aus: Die angegebene HBM4-Speicherkapazität schrumpfte von 2,3 auf 2 TB, und die Speicherbandbreite sank von 176 auf 130 TB/s. Auch die Bandbreite der NVLink-Switches ging von 28,8 auf 24 TB/s zurück. Bemerkenswert ist, dass die Bandbreite für Scale-out-Networking zur Verbindung mehrerer Systeme zu Clustern dagegen zunahm.
Leistungsanpassungen beim Modelltraining
Neben den reinen Speicher- und Schnittstelleneigenschaften hat Nvidia auch die Leistungskennzahlen beim Training neuronaler Netzwerke angepasst. Für das Format NVFP4 sank der Wert von 280 auf 270 Petaflops, bei den Formaten FP8/FP6 von 140 auf 130 Petaflops. Obwohl die absoluten Zahlen nach wie vor auf einem Niveau bleiben, das für Konkurrenzlösungen unerreichbar ist, könnte der Rückgang um 3–7 % im Kontext der langjährigen Versprechen des Unternehmens von Analysten als Signal gewertet werden, dass die in der Entwurfsphase festgelegten Zielwerte in der Serienfertigung nicht vollständig erreicht wurden.
Dokumentationsdiskrepanzen und Änderungschronologie
Auf der aktuellen Produktseite von HGX Rubin NVL8 auf der Nvidia-Website sind bereits die aktualisierten, gesenkten Spezifikationen aufgeführt, in der Tabelle für den einzelnen Rubin-Grafikprozessor stehen jedoch nach wie vor die alten Werte: 22 TB/s für den HBM4-Speicher und 3,6 TB/s für die NVLink-Schnittstelle. Auf einer separaten Seite, die DGX Rubin NVL8 gewidmet ist, werden ebenfalls weiterhin 2,3 TB Speicher und 176 TB/s Bandbreite angegeben. Nvidia hat nicht erklärt, ob diese Diskrepanzen auf unterschiedliche Hardwarekonfigurationen oder auf veraltete Dokumentation zurückzuführen sind. Eine Analyse archivierter Spezifikationsversionen durch das Portal Wccftech ergab, dass die Änderungen für das NVL72-System zwischen dem 1. und 11. September 2026 vorgenommen wurden.
Marktauswirkungen und Position von Nvidia
Aus wirtschaftlicher Sicht dürften derartige Anpassungen kaum nennenswerte Auswirkungen auf die Rubin-Verkäufe haben. Berichten zufolge wartet eine lange Schlange von Unternehmenskunden auf die Produkteinführung, und selbst die leicht reduzierten Plattformspezifikationen liegen deutlich über den Angeboten der Konkurrenz. Dennoch stellt die Überarbeitung der Spezifikationen eines KI-Flaggschiff-Beschleunigers wenige Monate vor der Massenauslieferung für die gesamte Branche einen Präzedenzfall dar, der das Vertrauen der Partner und die Erwartungen an nachfolgende Architekturgenerationen beeinflussen könnte. Bisher hüllt sich Nvidia zu den Gründen für die Überarbeitung in Schweigen – ob Produktionsengpässe beim HBM4-Speicher, thermische beziehungsweise elektrische Eigenschaften oder eine Neuausrichtung der Zielvorgaben bei der finalen Validierung vorliegen.