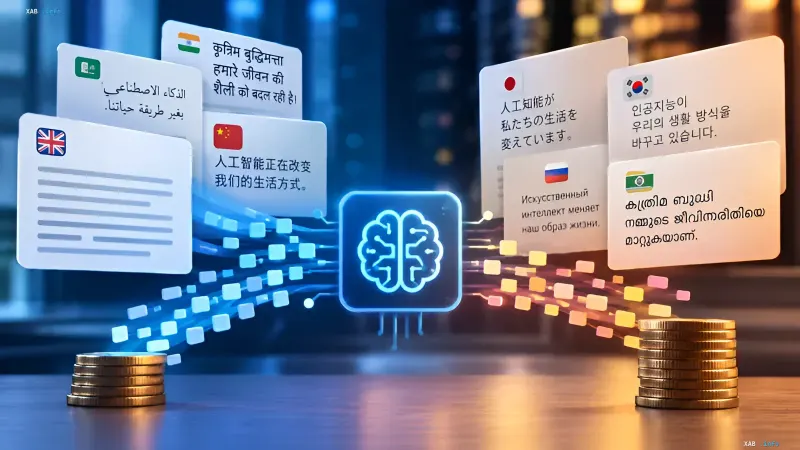
Двадцать лет назад цифровое неравенство сводилось к простому вопросу доступа: есть ли у человека подключение к интернету и устройство для его использования. Сегодня, когда нейросетевые ассистенты стали повседневным инструментом коммуникации, учёные выявили новый, более тонкий механизм дискриминации — «налог токенизатора» (tokenizer tax). Об этом сообщила Коалиция за языковое равенство в исследованиях искусственного интеллекта (CLEAR), опубликовав результаты анализа, основанного на корпусе параллельных переводов FLORES-200, охватывающем около 200 языков. По сути, носители малораспространённых языков платят за каждый запрос к языковой модели в разы больше, чем англоговорящие пользователи, даже если смысл введённого текста идентичен.
Как устроен «налог» и почему он возникает
Перед тем как языковая модель начинает обрабатывать входные данные, специальный алгоритм — токенизатор — разбивает текст, аудио или видео на фрагменты, называемые токенами. Именно по количеству токенов большинство коммерческих ИИ-сервисов рассчитывают стоимость использования модели. Проблема в том, что один и тот же по смыслу текст на разных языках разбивается на принципиально разное число фрагментов. Английский язык, будучи доминирующим в обучающих выборках большинства крупных моделей, «упаковывается» в токены наиболее эффективно. Для языков с иной морфологией, письменностью или уровнем представленности в данных тот же запрос может потребовать вдвое, втрое и даже в десятки раз больше токенов — а значит, и больше денег для пользователя или бизнеса.
Цифры: от полутора до семнадцати раз
Исследователи CLEAR сравнили обработку запросов на разных языках, опираясь на корпус FLORES-200, содержащий параллельные переводы предложений примерно на 200 языков. Среди 20 наиболее распространённых в интернете языков разница в количестве токенов между наиболее и наименее ресурсоёмкими вариантами одного и того же запроса составляла от 1,5 до 5 раз в зависимости от конкретной модели. При расширении выборки до всех 200 языков разрыв для отдельных моделей достигал 17 раз. В качестве наглядного примера авторы приводят фразу, которая на английском требует 13 токенов, а на малаялам — одном из языков южной Индии — 26. При этом подчёркивается, что строгого универсального соотношения стоимости не существует: результат зависит от конкретного текста и контекста, однако в большинстве случаев английский язык сохраняет структурное преимущество.
Сокращение контекста и вычислительная задержка
Помимо прямой финансовой нагрузки, «налог токенизатора» порождает ещё одно, возможно, более существенное ограничение — сокращение доступного объёма контекста. При фиксированном лимите токенов, отведённом на окно контекста модели, более ресурсоёмкий язык оставляет меньше места для загруженных документов, истории диалога, предыдущих сообщений и иных данных. Это означает, что пользователь, общающийся с ИИ на, скажем, бирманском или кхмерском языке, объективно получает менее «поместившийся» контекст, чем англоговорящий собеседник при том же тарифе. Дополнительно избыточные токены увеличивают вычислительную нагрузку на сервер и задержку формирования ответа, что делает взаимодействие с моделью медленнее и менее предсказуемым.
Какие языки страдают сильнее всего
Особенно заметные проблемы выявлены для языков, использующих письменности, слабо представленные в обучающих данных токенизаторов. Исследователи выделяют бирманский, тибетский, кхмерский и лаосский языки, а также языки, записываемые письменностями тифинаг (берберские языки Северной Африки) и ол-чики (языки Чхоттисгарха в Индии). При этом редкость языка сама по себе не является определяющим фактором: астурийский, например, может получать относительное преимущество благодаря использованию латинского алфавита и лексическому сходству с другими романскими языками, хорошо представленными в данных. Таким образом, ключевую роль играет не столько число носителей, сколько степень адаптации токенизатора к конкретной письменности и морфологической структуре языка.
Что предлагают исследователи и почему «само не рассосётся»
В качестве возможных путей сокращения разрыва специалисты CLEAR предлагают два основных направления: расширение представления качественных многоязычных данных в обучающих выборках и целенаправленная разработка токенизаторов, оптимизированных под различные письменности. При этом авторы подчёркивают, что простое увеличение объёма данных само по себе не гарантирует устранения проблемы — алгоритмы разбиения текста также требуют целенаправленного совершенствования. В заключении исследователи напоминают, что «само собой ничего не происходит»: сокращение цифрового неравенства в сфере искусственного интеллекта требует осознанных усилий со стороны разработчиков ИИ-моделей, которые должны принять идею языкового равенства как часть своей инженерной и этической повестки. Без такого системного подхода «налог токенизатора» будет продолжать расширять разрыв между англоязычным большинством и остальным миром по мере того, как ИИ проникает в образование, медицину, юриспруденцию и государственное управление.