NVIDIA публично объяснила философию, стоящую за её новым серверным процессором Vera: компания сознательно делает ставку на высокую производительность отдельных ядер, а не на их максимальное количество. По словам команды разработчиков, эпоха облачных вычислений навязала индустрии логику «чем больше ядер — тем лучше», однако массовое распространение ИИ-агентов вновь сделало скорость последовательных операций критически важным параметром. Vera, как следует из материалов платформы Rubin, построена на собственном ядре Olympus и рассчитана на то, чтобы не стать «узким местом» в связке с графическими ускорителями.
Почему «больше ядер» перестало работать для ИИ-агентов
Ключевой аргумент NVIDIA — архитектура работы ИИ-агентов. Такие системы постоянно переключаются между процессором и графическим ускорителем: CPU выполняет промежуточные задачи — запускает Python-скрипты, обращается к внешним инструментам, управляет окружением, — после чего GPU продолжает тяжёлые вычисления. Если процессор задерживается на любом из этих шагов, дорогостоящий ускоритель простаивает впустую. Именно поэтому Vera спроектирована с упором на высокую однопоточную производительность, пропускную способность памяти и низкие задержки. По заявлению компании, в задачах, типичных для ИИ-агентов, новинка до 1,5 раза быстрее своего предшественника Grace и до двух раз опережает ведущие x86-процессоры.
Монолитный кристалл против чиплетной компоновки
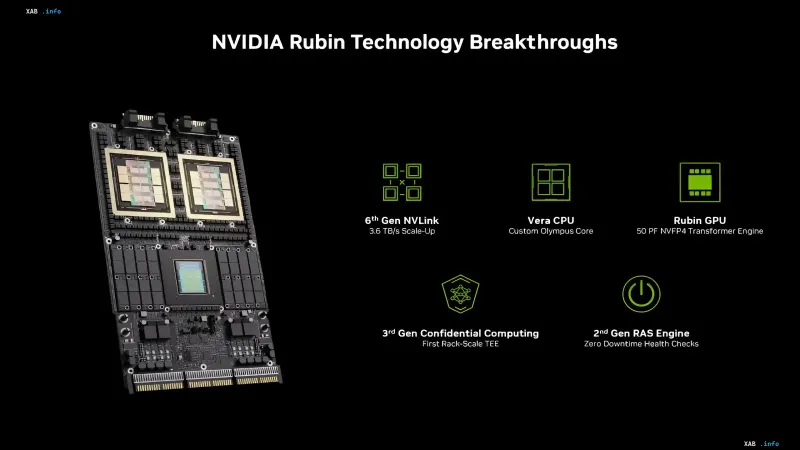
Второе принципиальное отличие Vera — отказ от чиплетной архитектуры, которую используют многие конкуренты. Вычислительный кристалл процессора выполнен монолитным: все ядра обмениваются данными без пересечения границ отдельных чиплетов, что устраняет связанные с этим задержки. NVIDIA заявляет о пропускной способности межъядерного обмена на уровне 3,4 ТБ/с — примерно втрое выше показателя ведущих x86-решений. В более широком контексте платформы Rubin это решение дополняется шестым поколением NVLink с пропускной способностью 3,6 ТБ/с в режиме Scale-Up, что в совокупности формирует высокоскоростную шину между CPU и GPU.
Spatial Multithreading и независимые тесты
Отдельным направлением развития стала технология Spatial Multithreading, которая разделяет ресурсы процессора между рабочими вычислительными потоками и операциями ввода-вывода, не позволяя им конкурировать за одни и те же каналы. По словам разработчиков, тестирование, проведённое Phoronix, зафиксировало прирост производительности порядка 20% при использовании этого механизма. Это один из немногих в материале показателей, полученных не самой NVIDIA, а внешним источником, что придаёт заявлению о преимуществах архитектуры дополнительную опору.
Что будет с соотношением CPU и GPU в ИИ-системах
NVIDIA не даёт конкретных прогнозов по соотношению процессоров и графических ускорителей в будущих ИИ-системах, однако указывает на устойчивый рост спроса на CPU для автономных серверных стоек. Такие процессоры смогут обслуживать многочисленные изолированные окружения для ИИ-агентов и задачи обучения с подкреплением, не занимая вычислительные ресурсы GPU. Логика здесь проста: чем больше «рутинной» агентной работы выносится на CPU, тем больше чистого времени GPU остаётся для генерации и обучения моделей. В совокупности с третьим поколением конфиденциальных вычислений и вторым поколением RAS-движка с проверками здоровья без простоя, о которых NVIDIA заявляет в рамках платформы Rubin, Vera выглядит как элемент более широкой стратегии — превратить серверную стойку в среду, где ИИ-агенты работают без взаимных блокировок.