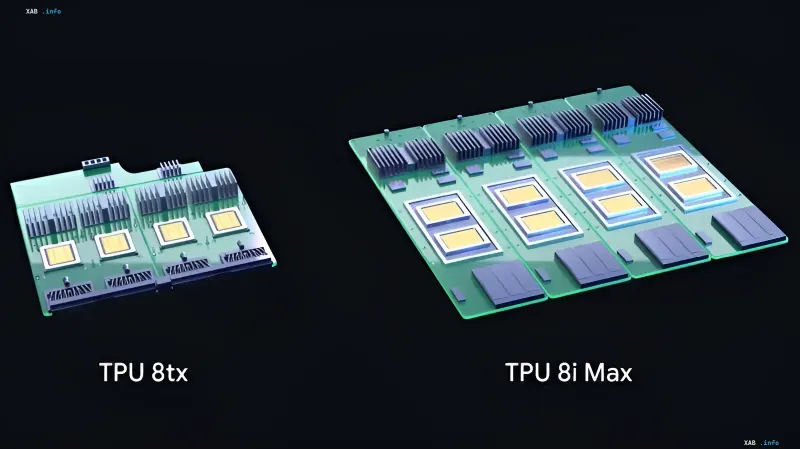
Google розширила лінійку тензорних процесорів (TPU) восьмого покоління, представивши дві нові системи — TPU 8tx та TPU 8i Max. За заявою компанії, обидві платформи оптимізовані під завдання, пов'язані з ШІ-агентами, а ключовими пріоритетами під час їх розробки стали безпека, висока щільність обчислень і покращені можливості логічного висновку. Разом із раніше анонсованими цього року TPU 8t та TPU 8i сімейство восьмого покоління тепер містить чотири моделі, кожна з яких розрахована на свій етап життєвого циклу ШІ.
Від чипа до системи: філософія восьмого покоління
Компанія наголошує, що презентує не просто чипи, а цілі системи на базі TPU. Розробка окремого чипа — багаторічний процес, обмежений законами фізики та тривалим виробничим циклом: йдеться про розміщення мільярдів мікроскопічних транзисторів на кремнієвій пластині. Система ж — це спосіб об'єднати навколо чипа обчислювальні потужності, мережеві ресурси та системи зберігання даних, включно з їх компонуванням, що дає змогу оперативно реагувати на нові потреби клієнтів і дослідницькі сценарії. Оскільки програмне забезпечення для ШІ розвивається швидше, ніж технології виробництва чипів, розробники зробили ставку на системний баланс і модульність, спроєктувавши TPU як «будівельні блоки» для платформи AI Hypercomputer.
TPU 8tx: конфіденційні обчислення на апаратному рівні
Система TPU 8tx створена для безпечного та конфіденційного виконання логічних операцій (інференсу) й орієнтована на державні організації та компанії зі суворо регульованих галузей, яким доводиться працювати з найбільш чутливими даними, використовуючи передові або проприєтарні моделі та автономних агентів. Безпека тут забезпечується на апаратному рівні: конфіденційні дані та ваги моделей залишаються захищеними й ізольованими навіть у процесі активного використання. За даними джерела, система поєднує TPU 8t з процесорами AMD EPYC п'ятого покоління та апаратним захистом даних. Впровадження мережі Boardfly з низькою затримкою дає змогу ефективно працювати багатокроковим агентам — затримка скорочується вдвічі порівняно з TPU 8t практично без втрати продуктивності. Команди можуть донавчати моделі на власних закритих даних, виконувати дистиляцію буйних моделей у компактні версії та навчати агентів методами навчання з підкріпленням, не переміщуючи конфіденційні дані між кластерами.
TPU 8i Max: подолання «бар'єра пам'яті»
Система TPU 8i Max спроєктована для роботи з величезними контекстними вікнами та забезпечення максимальної обчислювальної щільності на одну серверну стійку. Її ключова ідея — подолання так званого «бар'єра пам'яті» (memory wall): в єдиний модуль об'єднані два чипи TPU 8i, при цьому обчислювальна потужність і обсяг пам'яті масштабуються синхронно. Порівняно з базовою системою TPU 8i Max пропонує вдвічі більше обчислювальних ресурсів, вдвічі більше SRAM і вдвічі більшу пропускну здатність HBM. Це має допомогти під час обробки великих контекстів і одночасної роботи кількох агентів над великими проєктами.
Контекст: як розширювалася лінійка
Перші TPU були розроблені Google понад десять років тому для внутрішніх потреб компанії. Через вісім поколінь сфера їх застосування значно розширилася: тепер вони використовуються для навчання та запуску моделей Gemini, роботи ШІ-агентів, надання послуг клієнтам Google Cloud і розгортання безпосередньо в дата-центрах клієнтів. У квітні, на конференції Google Cloud Next, компанія представила дві базові системи покоління: TPU 8t для масштабного навчання та TPU 8i для логічних операцій у реальному часі. За даними Google, TPU 8t забезпечують до 2,7 раза вищу продуктивність під час навчання порівняно з попереднім поколінням, а TPU 8i — на 80 % вигідніше співвідношення ціни та продуктивності під час інференсу. TPU 8t забезпечує максимальний показник «корисної продуктивності» (goodput) — обсяг ефективних обчислень на кожен ват енергії, а TPU 8i скорочує затримки під час обміну даними між чипами аж до 50 %.
Екосистема та позиція компанії
Старший віцепрезидент і головний технолог Google з ШІ та інфраструктури Амін Вахдат описав призначення чотирьох систем восьмого покоління: TPU 8t — для масштабного навчання моделей, TPU 8i — для інференсу з низькою затримкою, TPU 8tx — для конфіденційних обчислень, а TPU 8i Max — для обробки величезних контекстних вікон і забезпечення максимальної щільності обчислень у серверній стійці. Разом із новими системами Google також представила супутні інструменти для роботи з прискорювачами, зокрема Agent Compute Engine, який зупиняє неактивні сесії ШІ-агентів і переносить їхню оперативну пам'ять із прискорювачів, щоб не займати обчислювальні ресурси, поки агент очікує відповіді від інструмента чи користувача.