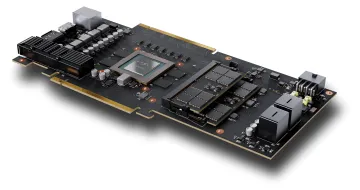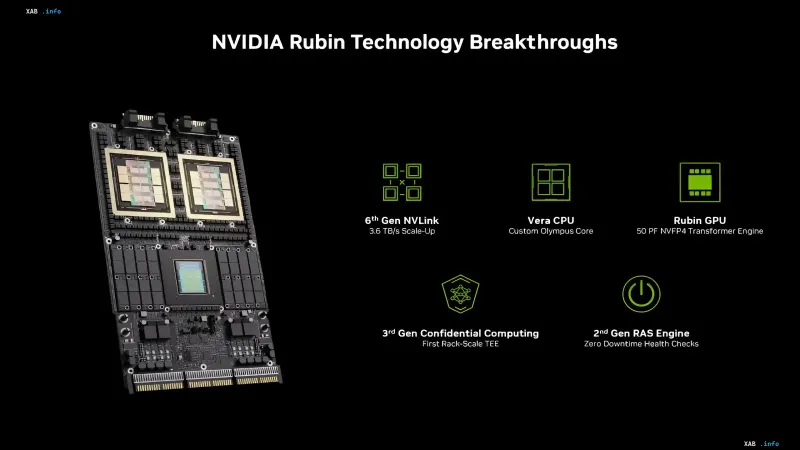
NVIDIA публічно пояснила філософію, що стоїть за її новим серверним процесором Vera: компанія свідомо робить ставку на високу продуктивність окремих ядер, а не на їх максимальну кількість. За словами команди розробників, епоха хмарних обчислень нав'язала індустрії логіку «що більше ядер — то краще», проте масове поширення ШІ-агентів знову зробило швидкість послідовних операцій критично важливим параметром. Vera, як випливає з матеріалів платформи Rubin, побудована на власному ядрі Olympus і розрахована на те, щоб не стати «вузьким місцем» у зв'язці з графічними прискорювачамі.
Чому «більше ядер» перестало працювати для ШІ-агентів
Ключовий аргумент NVIDIA — архітектура роботи ШІ-агентів. Такі системи постійно перемикаються між процесором і графічним прискорювачем: CPU виконує проміжні завдання — запускає Python-скрипти, звертається до зовнішніх інструментів, керує середовищем, — після чого GPU продовжує важкі обчислення. Якщо процесор затримується на будь-якому з цих кроків, дороговартісний прискорювач марно простоює. Саме тому Vera спроектована з упором на високу однопотокову продуктивність, пропускну здатність пам'яті та низькі затримки. За заявою компанії, в завданнях, типових для ШІ-агентів, новинка до 1,5 раза швидша за свого попередника Grace і до двох разів випереджає провідні x86-процесори.
Монолітний кристал проти чиплетного компонування
Друга принципова відмова Vera — відмова від чиплетної архітектури, яку використовують багато конкурентів. Обчислювальний кристал процесора виконано монолітним: усі ядра обмінюються даними без перетинання меж окремих чиплетів, що усуває пов'язані з цим затримки. NVIDIA заявляє про пропускну здатність міжядерного обміну на рівні 3,4 ТБ/с — приблизно втричі вище за показник провідних x86-рішень. У ширшому контексті платформи Rubin це рішення доповнюється шостим поколінням NVLink із пропускною здатністю 3,6 ТБ/с у режимі Scale-Up, що в сукупності формує високошвидкісну шину між CPU та GPU.
Spatial Multithreading і незалежні тести
Окремим напрямом розвитку стала технологія Spatial Multithreading, яка розділяє ресурси процесора між робочими обчислювальними потоками та операціями введення-виведення, не дозволяючи їм конкурувати за одні й ті самі канали. За словами розробників, тестування, проведене Phoronix, зафіксувало приріст продуктивності приблизно на 20% під час використання цього механізму. Це один із небагатьох у матеріалі показників, отриманих не самою NVIDIA, а зовнішнім джерелом, що надає заявві про переваги архітектури додаткової опори.
Що буде зі співвідношенням CPU та GPU в ШІ-системах
NVIDIA не дає конкретних прогнозів щодо співвідношення процесорів і графічних прискорювачів у майбутніх ШІ-системах, проте вказує на стійке зростання попиту на CPU для автономних серверних стійок. Такі процесори зможуть обслуговувати численні ізольовані середовища для ШІ-агентів і завдання навчання з підкредленням, не займаючи обчислювальні ресурси GPU. Логіка тут проста: що більше «рутинної» агентної роботи виноситься на CPU, то більше чистого часу GPU залишається для генерації та навчання моделей. У сукупності з третім поколінням конфіденційних обчислень і другим поколінням RAS-рушія з перевірками здоров'я без простою, про які NVIDIA заявляє в рамках платформи Rubin, Vera виглядає як елемент ширшої стратегії — перетворити серверну стійку на середовище, де ШІ-агенти працюють без взаємних блокувань.