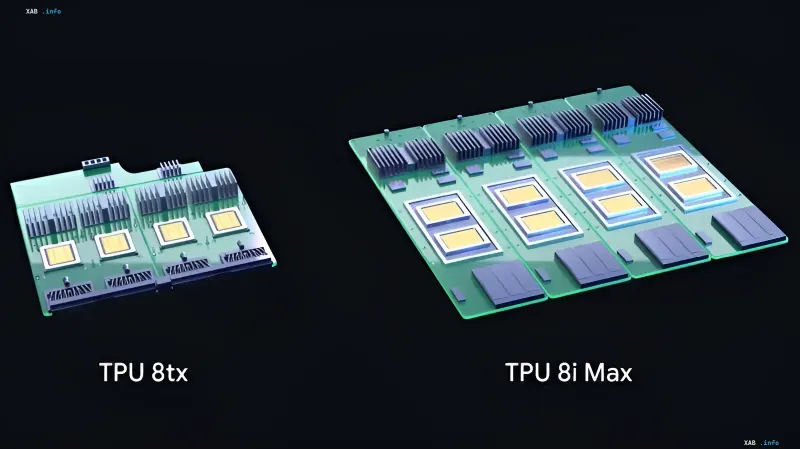
Google hat seine Tensor Processing Unit (TPU) der achten Generation um zwei neue Systeme erweitert: die TPU 8tx und die TPU 8i Max. Laut Unternehmensangaben sind beide Plattformen fur KI-Agenten-Workloads optimiert, wobei bei der Entwicklung Sicherheit, hohe Rechen- und Baudichte sowie verbesserte Inferenzfahigkeiten im Vordergrund standen. Zusammen mit den zu Jahresbeginn angekundigten TPU 8t und TPU 8i umfasst die Familie der achten Generation nun vier Modelle, die jeweils auf eine bestimmte Phase des KI-Lebenszyklus zugeschnitten sind.
Vom Chip zum System: Die Philosophie der achten Generation
Das Unternehmen betont, dass es nicht nur Chips, sondern komplette TPU-basierte Systeme vorstellt. Die Entwicklung eines einzelnen Chips ist ein mehrjahriger Prozess, der durch die Gesetze der Physik und lange Produktionszyklen eingeschrankt ist und die Platzierung von Milliarden mikroskopisch kleiner Transistoren auf einem Siliziumwafer erfordert. Ein System hingegen ist ein Ansatz, Rechenleistung, Netzwerkressourcen und Speichersysteme um den Chip herum zu integrieren, einschliesslich deren Anordnung, was eine schnelle Reaktion auf neue Kundenanforderungen und Forschungsszenarios ermoglicht. Da sich KI-Software schneller weiterentwickelt als die Chip-Fertigungstechnologie, haben die Entwickler auf Systemausgewogenheit und Modularitat gesetzt und TPUs als „Bausteine“ fur die AI Hypercomputer-Plattform konzipiert.
TPU 8tx: Vertrauliche Berechnungen auf Hardware-Ebene
Das TPU 8tx-System wurde fur sichere und vertrauliche Inferenzoperationen entwickelt und richtet sich an Behorden und Unternehmen in streng regulierten Branchen, die mit hochsensiblen Daten unter Verwendung fortschrittlicher oder proprietarer Modelle und autonomer Agenten arbeiten mussen. Die Sicherheit wird hier auf Hardware-Ebene gewahrleistet: Vertrauliche Daten und Modellgewichte bleiben selbst wahrend der aktiven Verarbeitung geschutzt und isoliert. Dem Vernehmen nach kombiniert das System die TPU 8t mit AMD EPYC-Prozessoren der funften Generation und einem Hardwaredatenschutz. Die Einfuhrung des Low-Latency-Netzwerks Boardfly ermoglicht mehrstufigen Agenten ein effizientes Arbeiten — die Latenz wird im Vergleich zur TPU 8t bei praktisch gleicher Leistung halbiert. Teams konnen Modelle mit eigenen geschlossenen Daten feinabstimmen, grosse Modelle in kompakte Versionen destillieren und Agenten mittels Reinforcement Learning trainieren, ohne sensible Daten zwischen Clustern zu verschieben.
TPU 8i Max: Uberwindung der „Speichermauer“
Das TPU 8i Max-System wurde fur die Arbeit mit riesigen Kontextfenstern und zur Gewahrleistung einer maximalen Rechen- und Baudichte pro Serverschrank entwickelt. Sein Kernkonzept ist die Uberwindung der sogenannten „Speichermauer“ (memory wall): Zwei TPU 8i-Chips sind zu einem einzigen Modul zusammengefasst, wobei Rechenleistung und Speicherkapazitat synchron skaliert werden. Im Vergleich zum Basissystem bietet die TPU 8i Max doppelt so viele Rechenressourcen, doppelt so viel SRAM und eine doppelt so hohe HBM-Bandbreite. Dies soll bei der Verarbeitung grosser Kontexte und der gleichzeitigen Arbeit mehrerer Agenten an Grossprojekten helfen.
Kontext: Wie sich die Produktlinie erweiterte
Die ersten TPUs wurden von Google vor uber zehn Jahren fur interne Zwecke entwickelt. Nach acht Generationen hat sich ihr Anwendungsbereich erheblich erweitert: Sie werden heute fur das Training und den Betrieb von Gemini-Modellen, die Arbeit von KI-Agenten, die Bereitstellung von Diensten fur Google Cloud-Kunden und den direkten Einsatz in Kundenzentren genutzt. Im April stellte das Unternehmen auf der Konferenz Google Cloud Next die beiden Basisysteme der Generation vor: die TPU 8t fur das massstabsgetreue Training und die TPU 8i fur Echtzeit-Inferenzoperationen. Google zufolge bietet die TPU 8t eine bis zu 2,7-mal hohere Trainingsleistung im Vergleich zur vorherigen Generation, wahrend die TPU 8i ein um 80 % besseres Preis-Leistungs-Verhaltnis bei der Inferenz bietet. Die TPU 8t maximiert die „nutzbare Leistung“ (Goodput) — das Volumen effektiver Berechnungen pro Watt Energie —, wahrend die TPU 8i die Latenz beim Datenaustausch zwischen Chips um bis zu 50 % reduziert.
Okosystem und Position des Unternehmens
Amin Vahdat, Senior Vice President und General Manager für Machine Learning, Systems und Cloud AI bei Google, beschrieb den Zweck der vier Systeme der achten Generation: die TPU 8t fur das massstabsgetreue Modelltraining, die TPU 8i fur Inferenz mit geringer Latenz, die TPU 8tx fur vertrauliche Berechnungen und die TPU 8i Max fur riesige Kontextfenster und maximale Rechen- und Baudichte im Serverschrank. Neben den neuen Systemen stellte Google auch Begleitwerkzeuge fur die Arbeit mit den Beschleunigern vor, insbesondere die Agent Compute Engine, die im Leerlauf befindliche KI-Agenten-Sitzungen pausiert und deren Arbeitsspeicher von den Beschleunigern auslagert, damit keine Rechenressourcen beansprucht werden, wahrend der Agent auf eine Antwort des Werkzeugs oder des Benutzers wartet.