Vor zwanzig Jahren lief die digitale Spaltung auf eine einfache Zugangsfrage hinaus: ob eine Person über einen Internetanschluss und ein Gerät zu dessen Nutzung verfügte. Heute, da neuronale Netzwerassistenten zu einem alltäglichen Kommunikationswerkzeug geworden sind, haben Forscher einen neuen, subtileren Diskriminierungsmechanismus identifiziert — die «Tokenizer-Steuer» (Tokenizer Tax). Dies teilte die Coalition for Language Equality in AI (CLEAR) mit und veröffentlichte die Ergebnisse einer Analyse, die auf dem parallelen Übersetzungskorpus FLORES-200 mit etwa 200 Sprachen basiert. Im Wesentlichen zahlen Sprecher weniger verbreiteter Sprachen für jede Anfrage an ein Sprachmodell ein Vielfaches mehr als englischsprachige Nutzer, selbst wenn der Inhalt des eingegebenen Textes identisch ist.
Wie die «Steuer» funktioniert und warum sie entsteht
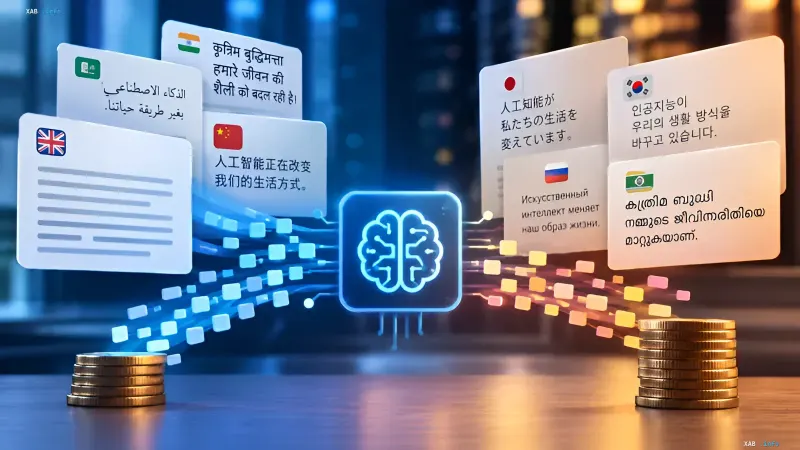
Bevor ein Sprachmodell beginnt, Eingabedaten zu verarbeiten, zerlegt ein spezieller Algorithmus — der Tokenizer — Text, Audio oder Video in Fragmente, sogenannte Token. Genau anhand der Anzahl der Token berechnen die meisten kommerziellen KI-Dienste die Kosten für die Nutzung des Modells. Das Problem besteht darin, dass derselbe sinngemäße Text in verschiedenen Sprachen in eine grundlegend unterschiedliche Anzahl von Fragmenten zerlegt wird. Die englische Sprache, die in den Trainingsdatensätzen der meisten großen Modelle dominiert, wird am effizientesten in Token «verpackt». Bei Sprachen mit einer anderen Morphologie, Schrift oder einem anderen Repräsentationsgrad in den Daten kann dieselbe Anfrage doppelt, dreimal oder sogar Dutzende Male mehr Token erfordern — und folglich mehr Geld für den Nutzer oder das Unternehmen.
Die Zahlen: Vom Eineinhalb- bis zum Siebzehnfachen
CLEAR-Forscher verglichen die Verarbeitung von Anfragen in verschiedenen Sprachen anhand des FLORES-200-Korpus, der parallele Übersetzungen von Sätzen in rund 200 Sprachen enthält. Unter den 20 im Internet am weitesten verbreiteten Sprachen lag der Unterschied in der Anzahl der Token zwischen den ressourcenintensivsten und den ressourcensparendsten Varianten derselben Anfrage je nach Modell zwischen dem 1,5- und 5-Fachen. Bei einer Erweiterung der Stichprobe auf alle 200 Sprachen erreichte die Kluft bei bestimmten Modellen das 17-Fache. Als anschauliches Beispiel nennen die Autoren eine Phrase, die auf Englisch 13 Token erfordert, auf Malayalam — einer südindischen Sprache — jedoch 26. Gleichzeitig wird betont, dass es kein strenges universelles Kostenverhältnis gibt: Das Ergebnis hängt vom jeweiligen Text und Kontext ab, in den meisten Fällen behält Englisch jedoch einen strukturellen Vorteil.
Kontextreduzierung und Latenz bei der Berechnung
Zusätzlich zur direkten finanziellen Belastung erzeugt die «Tokenizer-Steuer» eine weitere, möglicherweise noch bedeutendere Einschränkung — die Reduzierung des verfügbaren Kontextvolumens. Bei einem festen Token-Limit, das dem Kontextfenster des Modells zugewiesen ist, lässt eine ressourcenintensivere Sprache weniger Platz für geladene Dokumente, den Dialogverlauf, vorherige Nachrichten und andere Daten. Dies bedeutet, dass ein Nutzer, der mit einer KI auf, sagen wir, Birmanisch oder Khmer kommuniziert, objektiv einen weniger «untergebrachten» Kontext erhält als ein englischsprachiger Gesprächspartner zum selben Tarif. Darüber hinaus erhöhen überschüssige Token die Rechenlast des Servers und die Latenz bei der Antwortgenerierung, was die Interaktion mit dem Modell langsamer und weniger vorhersagbar macht.
Welche Sprachen am stärksten leiden
Besonders auffällige Probleme wurden für Sprachen festgestellt, die Schriftsysteme verwenden, die in den Trainingsdaten der Tokenizer unzureichend vertreten sind. Die Forscher heben Birmanisch, Tibetisch, Khmer und Laotisch hervor sowie Sprachen, die in Tifinagh (Berbersprachen Nordafrikas) und Ol Chiki (Sprachen von Chhattisgarh in Indien) geschrieben werden. Dabei ist die Seltenheit einer Sprache an sich kein ausschlaggebender Faktor: Asturisch beispielsweise kann aufgrund der Verwendung des lateinischen Alphabets und der lexikalischen Ähnlichkeit mit anderen romanischen Sprachen, die in den Daten gut vertreten sind, einen relativen Vorteil erhalten. Eine Schlüsselrolle spielt somit nicht so sehr die Sprecherzahl, sondern der Grad der Anpassung des Tokenizers an das spezifische Schriftsystem und die morphologische Struktur der Sprache.
Was Forscher vorschlagen und warum es sich nicht «von selbst löst»
Als mögliche Wege zur Schließung der Lücke schlagen CLEAR-Spezialisten zwei Hauptrichtungen vor: die Erweiterung der Repräsentation hochwertiger mehrsprachiger Daten in den Trainingssätzen und die gezielte Entwicklung von Tokenizern, die für verschiedene Schriftsysteme optimiert sind. Dabei betonen die Autoren, dass eine einfache Erhöhung des Datenvolumens allein die Beseitigung des Problems nicht garantiert — auch die Algorithmen zur Textaufteilung erfordern eine gezielte Verbesserung. Abschließend erinnern die Forscher daran, dass «sich nichts von alleine tut»: Die Verringerung der digitalen Spaltung im Bereich der künstlichen Intelligenz erfordert bewusste Anstrengungen seitens der Entwickler von KI-Modellen, die die Idee der sprachlichen Gleichheit als Teil ihrer ingenieurtechnischen und ethischen Agenda annehmen müssen. Ohne einen solchen systemischen Ansatz wird die «Tokenizer-Steuer» die Kluft zwischen der englischsprachigen Mehrheit und dem Rest der Welt weiter vergrößern, während die KI in Bildung, Medizin, Rechtsprechung und öffentliche Verwaltung vordringt.