Google расширила линейку тензорных процессоров (TPU) восьмого поколения, представив две новые системы — TPU 8tx и TPU 8i Max. По заявлению компании, обе платформы оптимизированы под задачи, связанные с ИИ-агентами, а ключевыми приоритетами при их разработке стали безопасность, высокая плотность вычислений и улучшенные возможности логического вывода. Вместе с ранее анонсированными в этом году TPU 8t и TPU 8i семейство восьмого поколения теперь включает четыре модели, каждая из которых рассчитана на свой этап жизненного цикла ИИ.
От чипа к системе: философия восьмого поколения
Компания подчёркивает, что представляет не просто чипы, а целые системы на базе TPU. Разработка отдельного чипа — многолетний процесс, ограниченный законами физики и длительным производственным циклом: речь идёт о размещении миллиардов микроскопических транзисторов на кремниевой пластине. Система же — это способ объединить вокруг чипа вычислительные мощности, сетевые ресурсы и системы хранения данных, включая их компоновку, что позволяет оперативно реагировать на новые потребности клиентов и исследовательские сценарии. Поскольку программное обеспечение для ИИ развивается быстрее, чем технологии производства чипов, разработчики сделали ставку на системный баланс и модульность, спроектировав TPU как «строительные блоки» для платформы AI Hypercomputer.
TPU 8tx: конфиденциальные вычисления на аппаратном уровне
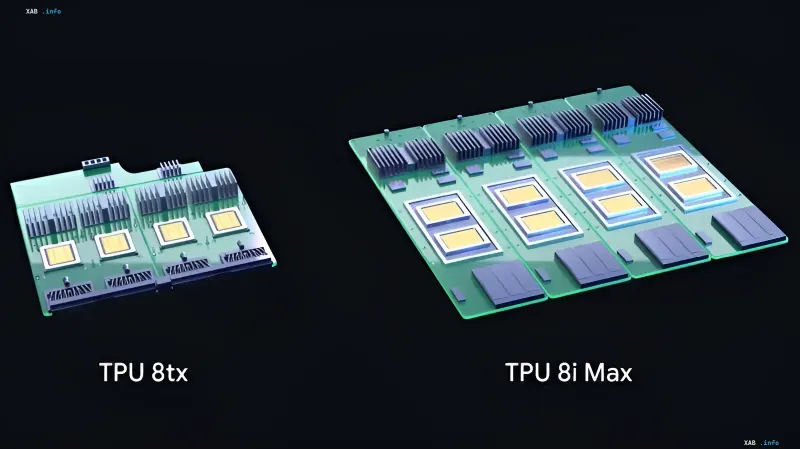
Система TPU 8tx создана для безопасного и конфиденциального выполнения логических операций (инференса) и ориентирована на государственные организации и компании из строго регулируемых отраслей, которым приходится работать с наиболее чувствительными данными, используя передовые или проприетарные модели и автономных агентов. Безопасность здесь обеспечивается на аппаратном уровне: конфиденциальные данные и веса моделей остаются защищёнными и изолированными даже в процессе активного использования. По данным источника, система сочетает TPU 8t с процессорами AMD EPYC пятого поколения и аппаратной защитой данных. Внедрение сети Boardfly с низкой задержкой позволяет эффективно работать многошаговым агентам — задержка сокращается вдвое по сравнению с TPU 8t практически без потери производительности. Команды могут дообучать модели на собственных закрытых данных, выполнять дистилляцию крупных моделей в компактные версии и обучать агентов методами обучения с подкреплением, не перемещая конфиденциальные данные между кластерами.
TPU 8i Max: преодоление «барьера памяти»
Система TPU 8i Max спроектирована для работы с огромными контекстными окнами и обеспечения максимальной вычислительной плотности на одну серверную стойку. Её ключевая идея — преодоление так называемого «барьера памяти» (memory wall): в единый модуль объединены два чипа TPU 8i, при этом вычислительная мощность и объём памяти масштабируются синхронно. По сравнению с базовой системой TPU 8i Max предлагает вдвое больше вычислительных ресурсов, вдвое больше SRAM и вдвое большую пропускную способность HBM. Это должно помочь при обработке больших контекстов и одновременной работе нескольких агентов над крупными проектами.
Контекст: как расширялась линейка
Первые TPU были разработаны Google более десяти лет назад для внутренних нужд компании. Спустя восемь поколений сфера их применения значительно расширилась: теперь они используются для обучения и запуска моделей Gemini, работы ИИ-агентов, предоставления услуг клиентам Google Cloud и развёртывания непосредственно в дата-центрах клиентов. В апреле, на конференции Google Cloud Next, компания представила две базовые системы поколения: TPU 8t для масштабного обучения и TPU 8i для логических операций в реальном времени. По данным Google, TPU 8t обеспечивают до 2,7 раза более высокую производительность при обучении по сравнению с предыдущим поколением, а TPU 8i — на 80 % более выгодное соотношение цены и производительности при инференсе. TPU 8t обеспечивает максимальный показатель «полезной производительности» (goodput) — объём эффективных вычислений на каждый ватт энергии, а TPU 8i сокращает задержки при обмене данными между чипами вплоть до 50 %.
Экосистема и позиция компании
Старший вице-президент и главный технолог Google по ИИ и инфраструктуре Амин Вахдат описал назначение четырёх систем восьмого поколения: TPU 8t — для масштабного обучения моделей, TPU 8i — для инференса с низкой задержкой, TPU 8tx — для конфиденциальных вычислений, а TPU 8i Max — для обработки огромных контекстных окон и обеспечения максимальной плотности вычислений в серверной стойке. Вместе с новыми системами Google также представила сопутствующие инструменты для работы с ускорителями, в частности Agent Compute Engine, который приостанавливает простаивающие сессии ИИ-агентов и переносит их рабочую память с ускорителей, чтобы не занимать вычислительные ресурсы, пока агент ожидает ответа от инструмента или пользователя.