Двадцять років тому цифрова нерівність зводилася до простого питання доступу: чи є у людини підключення до інтернету та пристрій для його використання. Сьогодні, коли нейромережеві асистенти стали повсякденним інструментом комунікації, вчені виявили новий, більш тонкий механізм дискримінації — «податок токенізатора» (tokenizer tax). Про це повідомила Коаліція за мовну рівність у дослідженнях штучного інтелекту (CLEAR), опублікувавши результати аналізу, заснованого на корпусі паралельних перекладів FLORES-200, що охоплює близько 200 мов. По суті, носії малопоширених мов платять за кожен запит до мовної моделі в рази більше, ніж англомовні користувачі, навіть якщо зміст введеного тексту ідентичний.
Як влаштований «податок» і чому він виникає
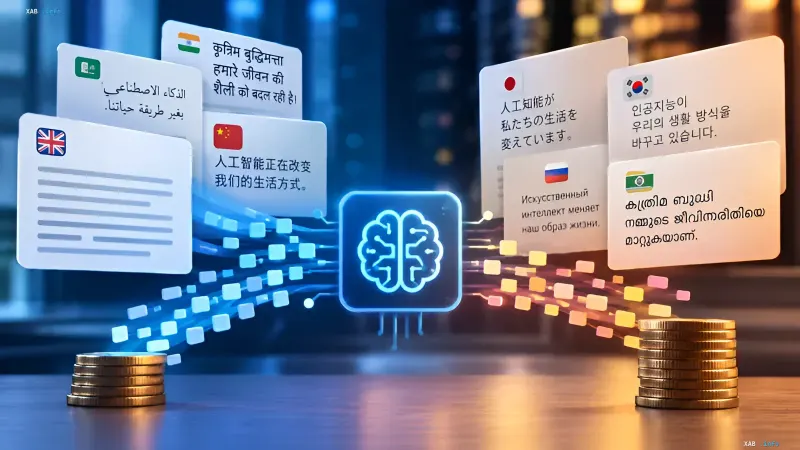
Перед тим як мовна модель починає обробляти вхідні дані, спеціальний алгоритм — токенізатор — розбиває текст, аудіо чи відео на фрагменти, які називаються токенами. Саме за кількістю токенів більшість комерційних ШІ-сервісів розраховують вартість використання моделі. Проблема в тому, що один і той самий за змістом текст різними мовами розбивається на принципово різну кількість фрагментів. Англійська мова, будучи домінуючою у навчальних вибірках більшості великих моделей, «пакується» в токени найефективніше. Для мов з іншою морфологією, писемністю чи рівнем представленості в даних той самий запит може потребувати вдвічі, втричі й навіть у десятки разів більше токенів — а отже, і більше грошей для користувача чи бізнесу.
Цифри: від півтора до сімнадцяти разів
Дослідники CLEAR порівняли обробку запитів різними мовами, спираючись на корпус FLORES-200, що містить паралельні переклади речень приблизно на 200 мов. Серед 20 найпоширеніших в інтернеті мов різниця в кількості токенів між найменш і найбільш ресурсомісткими варіантами одного й того ж запиту становила від 1,5 до 5 разів залежно від конкретної моделі. При розширенні вибірки до всіх 200 мов розрив для окремих моделей досягав 17 разів. Як наочний приклад автори наводять фразу, яка англійською вимагає 13 токенів, а малалаямом — однією з мов південної Індії — 26. При цьому наголошується, що суворого універсального співвідношення вартості не існує: результат залежить від конкретного тексту та контексту, проте в більшості випадків англійська мова зберігає структурну перевагу.
Скорочення контексту та обчислювальна затримка
Окрім прямого фінансового навантаження, «податок токенізатора» породжує ще одне, можливо, більш суттєве обмеження — скорочення доступного обсягу контексту. За фіксованого ліміту токенів, відведеного на вікно контексту моделі, більш ресурсомістка мова залишає менше місця для завантажених документів, історії діалогу, попередніх повідомлень та інших даних. Це означає, що користувач, який спілкується з ШІ скажімо, бірманською чи кхмерською мовою, об'єктивно отримує менш «поміщений» контекст, ніж англомовний співрозмовник за того самого тарифу. Додатково надлишкові токени збільшують обчислювальне навантаження на сервер і затримку формування відповіді, що робить взаємодію з моделлю повільнішою та менш передбачуваною.
Які мови страждають найбільше
Особливо помітні проблеми виявлено для мов, що використовують писемності, слабо представлені у навчальних даних токенізаторів. Дослідники виділяють бірманську, тибетську, кхмерську та лаоську мови, а також мови, що записуються писемностями тифінаг (берберські мови Північної Африки) та ол-чики (мови Чхоттисгарха в Індії). При цьому рідкісність мови сама по собі не є визначальним фактором: астурійська, наприклад, може отримувати відносну перевагу завдяки використанню латинського алфавіту та лексичній подібності з іншими романськими мовами, добре представленими в даних. Таким чином, ключову роль відіграє не стільки кількість носіїв, скільки ступінь адаптації токенізатора до конкретної писемності та морфологічної структури мови.
Що пропонують дослідники і чому «само не розсмокчеться»
Як можливі шляхи скорочення розриву фахівці CLEAR пропонують два основні напрями: розширення представлення якісних багатомовних даних у навчальних вибірках та цілеспрямована розробка токенізаторів, оптимізованих під різні писемності. При цьому автори наголошують, що просте збільшення обсягу даних саме по собі не гарантує усунення проблеми — алгоритми розбиття тексту також вимагають цілеспрямованого вдосконалення. На закінчення дослідники нагадують, що «само собою нічого не відбувається»: скорочення цифрової нерівності у сфері штучного інтелекту вимагає усвідомлених зусиль з боку розробників ШІ-моделей, які мають прийняти ідею мовної рівності як частину своєї інженерної та етичної повістки. Без такого системного підходу «податок токенізатора» продовжуватиме розширювати розрив між англомовною більшістю та рештою світу в міру того, як ШІ проникає в освіту, медицину, юриспруденцію та державне управління.