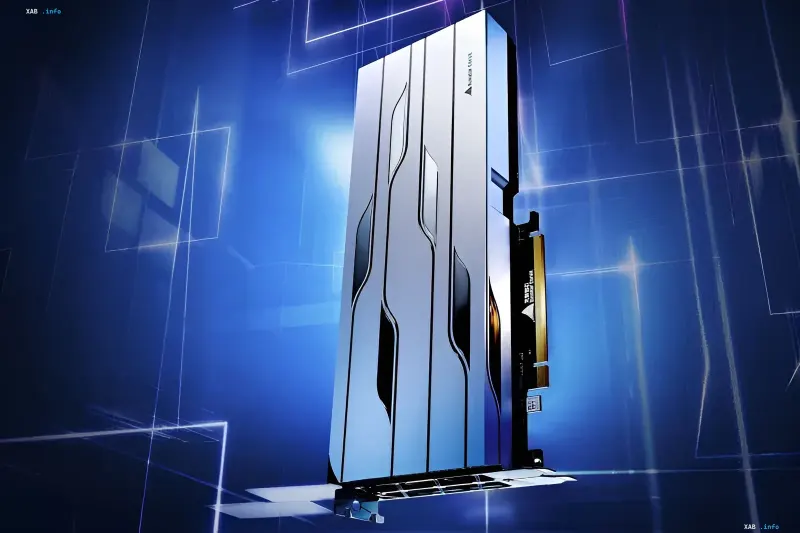
Das chinesische Unternehmen Iluvatar CoreX hat bekannt gegeben, dass sein Allzweck-Grafikbeschleuniger Tiangai 300 mit der Nvidia H200 konkurrieren kann – Nvidias fortschrittlichstem KI-Beschleuniger, der gemäß den aktuellen US-Vorschriften nach China exportiert werden darf. Während einer Vorführung in Shanghai präsentierte der Hersteller Journalisten die Ergebnisse von Vergleichstests und zeigte die Hardware im Betrieb. Dabei weist das Unternehmen jedoch darauf hin, dass die genauen Vergleichsbedingungen und die Berechnungsmethoden für einige Kennzahlen nicht vollständig offengelegt wurden, was eine unabhängige Überprüfung der genannten Zahlen einschränkt.
Bilderzeugung: 100% gegenüber 87,5%
In einem Test zur Texterstellung von Bildern schloss das Tiangai-300-System 100% der Anfragen mit einem Durchsatz von 0,101 Bildern pro Sekunde erfolgreich ab, während das H200-System 87,5% der Anfragen bei 0,086 Bildern pro Sekunde bewältigte. Gleichzeitig war die Abschlusszeit der Aufgabe beim chinesischen Beschleuniger um 0,64 Sekunden länger. Das Unternehmen spezifiziert die Kriterien für den erfolgreichen Abschluss von Anfragen und die Berechnungsmethode nicht, weshalb ein direkter Vergleich dieser Zahlen mit Vorsicht zu genießen ist.
Dritter Anbieter und Prefill/Decode-Konfiguration
Laut Iluvatar CoreX zeigte ein im Juli vom in Shanghai ansässigen Unternehmen INESA durchgeführter Test, dass das Tiangai-300-System einen um 5% höheren Durchsatz pro Beschleuniger liefert als das H200-System. Die Tests wurden in einer Konfiguration mit getrennter Verarbeitung eingehender Anfragen (Prefill) und Antwortgenerierung (Decode) durchgeführt. Der Hersteller behauptet, dass der Tiangai 300 der erste chinesische Allzweck-GPU ist, der in solchen Tests das H200-Niveau erreicht hat.
LLM-Arbeitslasten und Modelltraining
In einem anderen Test übertraf der Tiangai 300 nach Angaben des Unternehmen den H200 beim Durchsatz um 15%, als das Modell GLM-5.3 auf einer MoE-Architektur (Mixture-of-Experts) mit einem Kontext von 64k Token ausgeführt wurde. Bei KI-Agenten-Aufgaben mit Kontexten von 8k bis 128k Token war die Zeit bis zum ersten Token (Time-to-First-Token) um 10 bis 30% niedriger. Bei einer Demonstration des Trainings des offenen Modells Alibaba Qwen3-32B lieferte ein mit FP8-Präzision ausgestattetes Acht-Karten-System auf Basis von Tiangai 300 einen um das 1,33-fache höheren effektiven Durchsatz pro Karte als ein System auf Basis von Nvidia H100.
Roadmap und Bereitstellungsmaßstab
Iluvatar CoreX verringert den Rückstand auf Nvidia kontinuierlich: Im Januar veröffentlichte das Unternehmen eine langfristige Architektur-Roadmap, wonach es beabsichtigt, die Nvidia-Rubin-Plattform innerhalb von zwei Jahren zu übertreffen. Nach Angaben des Herstellers werden Beschleuniger der Tiangai-Serie bereits in Systemen im Umfang von Zehntausenden von Karten eingesetzt, wodurch Erfahrungen bei deren Implementierung und Wartung gesammelt werden. Das Unternehmen expandiert auch über Cloud-Rechenzentren hinaus und entwickelt Lösungen für lokale KI-Anwendungen: Das Rechensystem Tongyang TY1200 übertraf in bestimmten Tests großer Sprachmodelle eine Lösung auf Basis des Nvidia Thor T5000 um 20%.
Einschränkungen der beanspruchten Ergebnisse
Es ist wichtig zu beachten, dass sich alle angeführten Zahlen auf ausgewählte Arbeitslasten beziehen und keine allgemeine Überlegenheit des Tiangai 300 gegenüber dem Wettbewerber belegen. Erfolgskriterien, Konfigurationen und Methoden einiger Tests wurden nicht vollständig offengelegt, und einige Tests wurden vom Unternehmen selbst oder seinem Partner durchgeführt. Daher sollte die Erklärung von Iluvatar CoreX als ein bedeutender, aber noch nicht vollständig verifizierbarer Schritt der chinesischen Industrie in Richtung Parität mit Nvidias Flaggschiff-KI-Beschleunigern betrachtet werden.