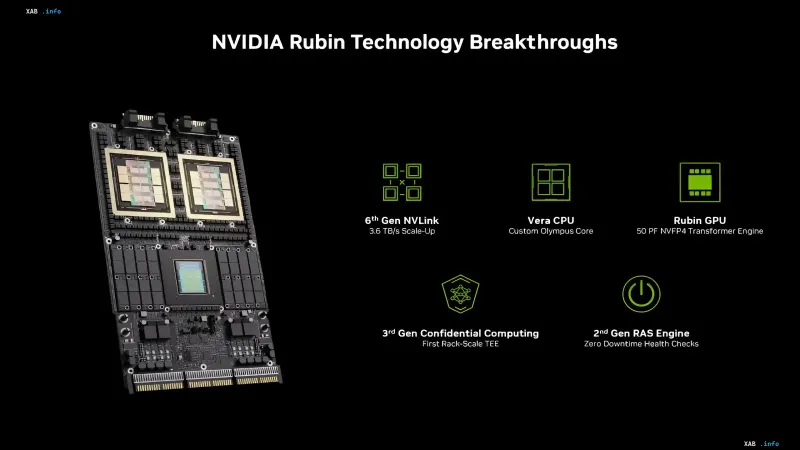
NVIDIA hat öffentlich die Philosophie hinter seinem neuen Serverprozessor Vera dargelegt: Das Unternehmen setzt bewusst auf eine hohe Leistung einzelner Kerne anstelle einer maximalen Kernanzahl. Laut dem Entwicklerteam hat die Ära des Cloud-Computing der Branche die Logik „je mehr Kerne, desto besser“ aufgedrängt; die massenhafte Verbreitung von KI-Agenten hat jedoch die Geschwindigkeit sequenzieller Operationen wieder zu einem kritischen Parameter gemacht. Vera, wie aus den Materialien der Rubin-Plattform hervorgeht, basiert auf einem eigenen Olympus-Kern und ist so konzipiert, dass sie im Zusammenspiel mit Grafikbeschleunigern kein „Nadelöhr“ bildet.
Warum „mehr Kerne“ für KI-Agenten nicht mehr funktioniert
NVIDIAs Hauptargument ist die Architektur der KI-Agenten-Workloads. Solche Systeme wechseln ständig zwischen Prozessor und Grafikbeschleuniger: Die CPU erledigt Zwischenaufgaben — führt Python-Skripte aus, greift auf externe Tools zu, verwaltet die Umgebung —, woraufhin die GPU die schweren Berechnungen fortsetzt. Wenn der Prozessor bei einem dieser Schritte ins Stocken gerät, läuft der teure Beschleuniger leer. Genau deshalb ist Vera mit Schwerpunkt auf hoher Einzelkern-Leistung, Speicherbandbreite und niedrigen Latenzen konzipiert. Nach Angaben des Unternehmens ist die Neuheit bei typischen KI-Agenten-Aufgaben bis zu 1,5-mal schneller als ihr Vorgänger Grace und bis zu doppelt so schnell wie führende x86-Prozessoren.
Monolithischer Die im Vergleich zum Chiplet-Design
Der zweite grundlegende Unterschied von Vera ist der Verzicht auf die Chiplet-Architektur, die von vielen Wettbewerbern genutzt wird. Der Rechen-Die des Prozessors ist monolithisch ausgeführt: Alle Kerne tauschen Daten aus, ohne die Grenzen einzelner Chiplets zu überschreiten, wodurch damit verbundene Latenzen entfallen. NVIDIA gibt eine Inter-Core-Kommunikationsbandbreite von 3,4 TB/s an — etwa das Dreifache führender x86-Lösungen. Im breiteren Kontext der Rubin-Plattform wird dies durch die sechste Generation von NVLink mit einer Bandbreite von 3,6 TB/s im Scale-Up-Modus ergänzt, was zusammen einen Hochgeschwindigkeitsbus zwischen CPU und GPU bildet.
Spatial Multithreading und unabhängige Benchmarks
Ein separater Entwicklungsbereich ist die Spatial Multithreading-Technologie, die Prozessorressourcen zwischen Arbeits-Threads und E/A-Operationen aufteilt und verhindert, dass sie um dieselben Kanäle konkurrieren. Laut den Entwicklern verzeichneten von Phoronix durchgeführte Tests einen Leistungszuwachs von rund 20 % bei Verwendung dieses Mechanismus. Dies ist einer der wenigen Werte im Material, die nicht von NVIDIA selbst, sondern von einer externen Quelle stammen, was den Aussagen über die architektonischen Vorteile zusätzliches Gewicht verleiht.
Wie sich das Verhältnis von CPU und GPU in KI-Systemen entwickeln wird
NVIDIA gibt keine konkreten Prognosen zum Verhältnis von Prozessoren und Grafikbeschleunigern in zukünftigen KI-Systemen ab, verweist jedoch auf eine stetig wachsende Nachfrage nach CPUs für autonome Serverracks. Solche Prozessoren werden in der Lage sein, zahlreiche isolierte Umgebungen für KI-Agenten und Reinforcement-Learning-Aufgaben zu bedienen, ohne die Rechenressourcen der GPU zu beanspruchen. Die Logik dahinter ist einfach: Je mehr „routinehafte“ Agentenarbeit auf die CPU ausgelagert wird, desto mehr reine GPU-Zeit bleibt für die Generierung und das Training von Modellen übrig. Zusammen mit der dritten Generation des vertraulichen Computings (Confidential Computing) und dem RAS-Engine der zweiten Generation mit ausfallfreien Integritätsprüfungen, die NVIDIA im Rahmen der Rubin-Plattform ankündigt, wirkt Vera wie ein Element einer umfassenderen Strategie — das Serverrack in eine Umgebung zu verwandeln, in der KI-Agenten ohne gegenseitige Blockaden arbeiten.